 hiData
 芦笋提词器
 InStreet
 Mercor
 Papers with Code
 Excalidraw
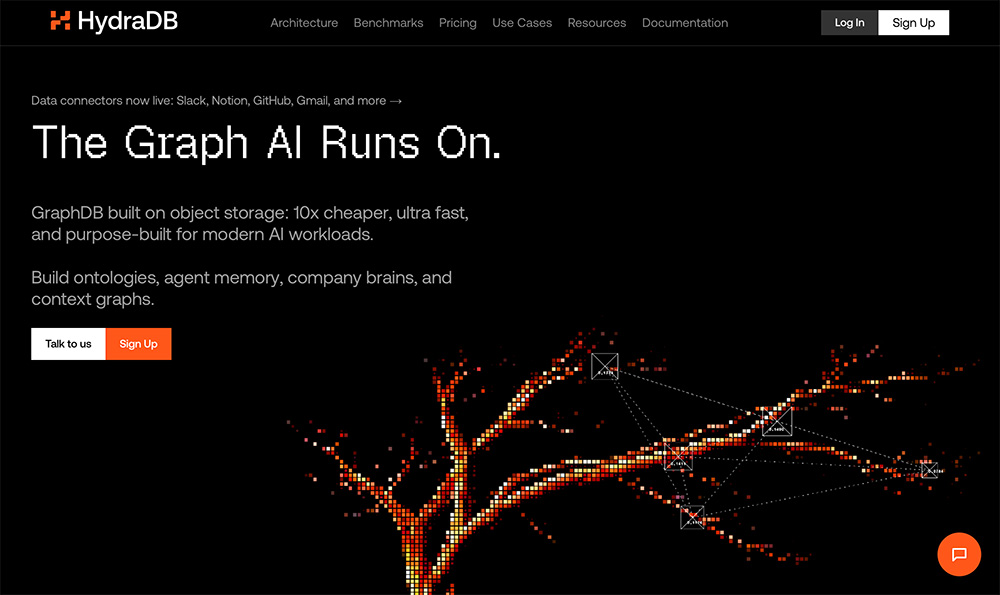
HydraDB是开源原生图数据库,主打AI上下文基础设施,专为智能体记忆、知识本体、企业大脑、GraphRAG及强关联业务数据场景设计。数据库原生构建于对象存储之上,融合图遍历、向量检索、精确匹配、时间版本管理与结构化关系能力,为AI系统提供精准、关联、可追溯的上下文数据。
平台支持多租户架构、强一致性查询,采用内存、NVMe SSD、对象存储三层分层存储,查询延迟低于200ms,兼容OpenCypher、Neo4j Bolt协议与标准HTTP API,是AI智能体与知识检索场景的底层核心数据库。
一、产品核心功能:
1、分层原生图存储架构:基于对象存储构建,支持热、温、冷数据分层管理,兼顾性能与存储成本。
2、AI融合上下文检索:一体化整合图关系遍历、向量相似度搜索、关键词精确匹配,输出关联性更强的结构化上下文。
3、企业级多租户能力:多租户隔离架构,支持强一致性查询,常规查询延迟稳定低于200ms。
4、全面查询协议兼容:原生支持OpenCypher,兼容Neo4j Bolt连接方式与标准HTTP API,迁移成本极低。
5、时序记忆与实体管理:内置时间版本管理、实体解析、偏好感知检索,适配AI智能体持久记忆场景。
6、多源业务数据接入:支持企业办公、邮件、CRM、文档等多类业务数据源快速对接入库。
7、可视化可观测能力:提供追踪与观测面板,可追溯AI智能体决策依据、行动链路与上下文来源。
二、典型使用场景:
1、搭建AI智能体持久化记忆体系,长期留存用户偏好、交互记录与任务执行轨迹。
2、聚合文档、办公数据、聊天记录、业务信息,构建企业知识图谱与私有企业大脑。
3、落地高阶GraphRAG系统,检索相互关联的结构化上下文,替代碎片化、孤立的文档匹配。
4、为客服智能体提供具备关系感知、时序准确的完整对话与业务上下文。
5、打造AI编程助手,理解代码仓库结构、任务问题、依赖关系与历史智能体操作记录。
6、搭建研究情报系统,串联实体、事件、信息来源与知识演变链路。
7、为办公类AI应用搭建标准化上下文工程与智能体自动化工作流。
三、标准使用流程:
1、注册HydraDB服务,安装官方SDK,或通过兼容Neo4j的Bolt协议、HTTP API完成连接。
2、批量导入智能体日志、知识库文档、企业办公数据、用户记忆与各类业务知识源。
3、使用OpenCypher构建知识图谱与上下文查询逻辑,组合图遍历、向量搜索、BM25、重排序、数据过滤能力。
4、检索结构化、关联化、时序准确的上下文数据,供给AI智能体用于推理、决策与回答生成。
5、通过观测面板追踪检索链路与智能体行为,持续优化知识检索与上下文工程效果。
数据统计
特别声明&浏览提醒
本站AI工具导航站提供的「HydraDB」的相关内容都来源于网络,不保证外部链接的准确性和完整性。在2026年09月09日 08时38分48秒收录时,该网站上的内容都属于合规合法,后期网站的内容如出现违规,可以直接联系网站管理员(ai@ipkd.cn)进行删除,AI工具导航站不承担任何责任。在浏览网页时,请注意您的账号和财产安全,切勿轻信网上广告!
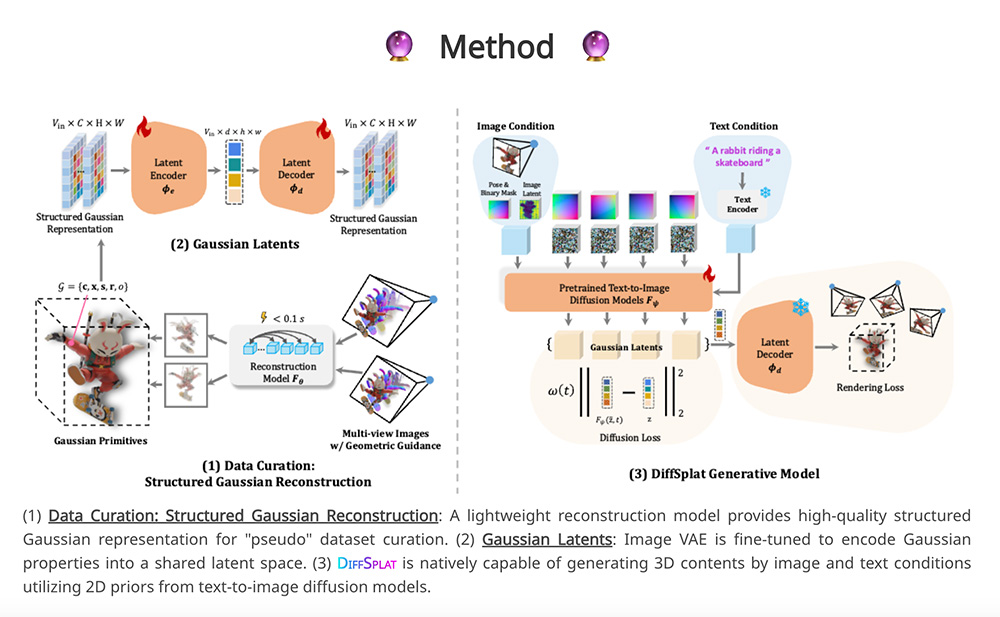 几款免费AI 3D模型生成工具,快速制作逼真三维模型!
 盘点12个夸克网盘电影免费播放观看
 11款免费AI思维导图工具,一键生成高效思维图
 几款免费AI视频转动漫神器,一键生成超酷动画片!
 几款免费AI绘图工具,一键生成流程图与办公图表
 6款免费AI视频剪辑软件,智能自动编辑,省钱又高效
 多款免费AI声音克隆工具,精准复刻音色,你也可以当主播
 盘点8个欧美电影免费观看电视剧大全
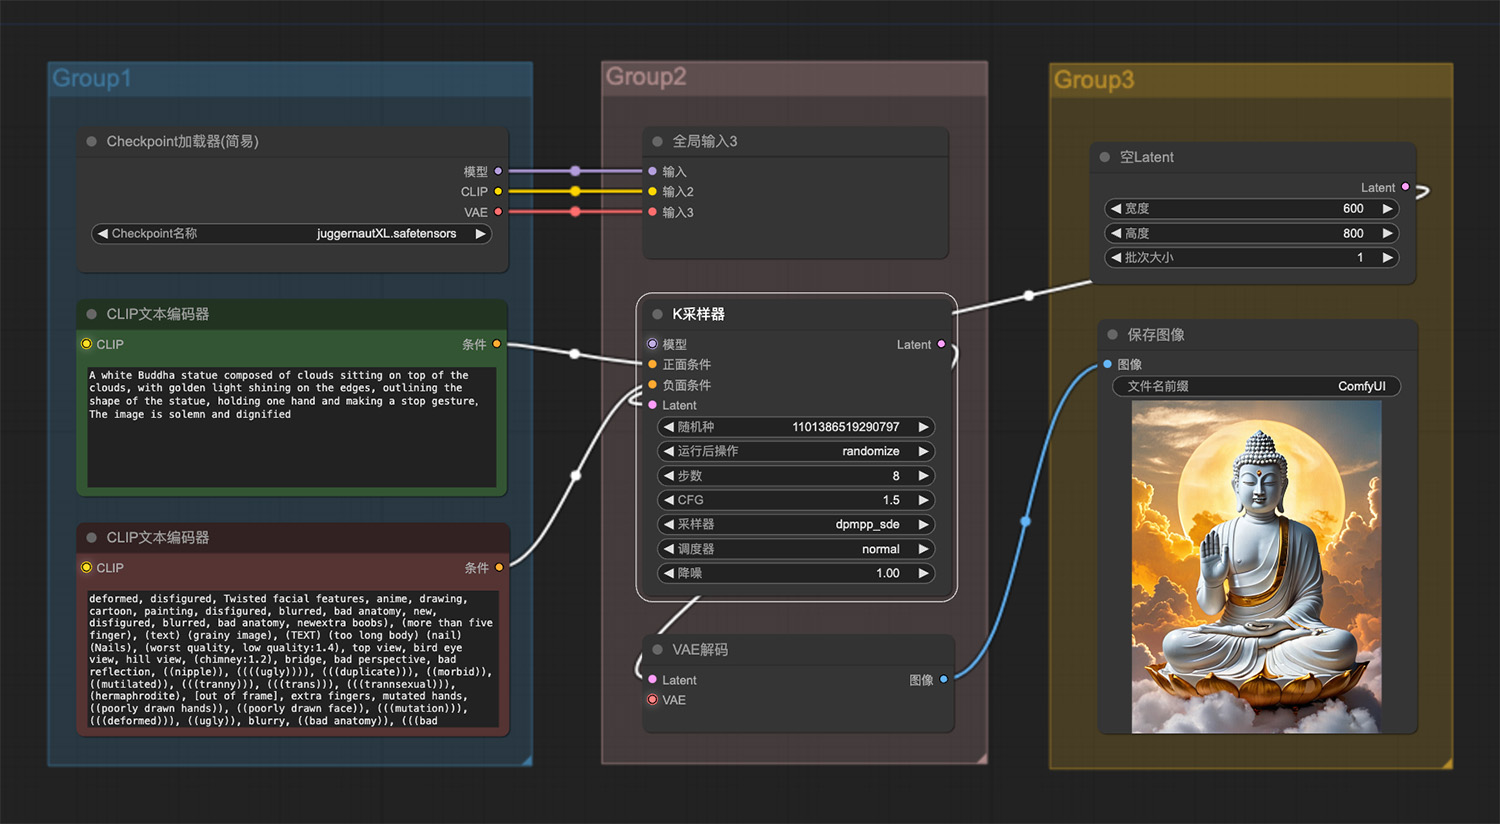 一尊白玉佛像ComfyUI工作流
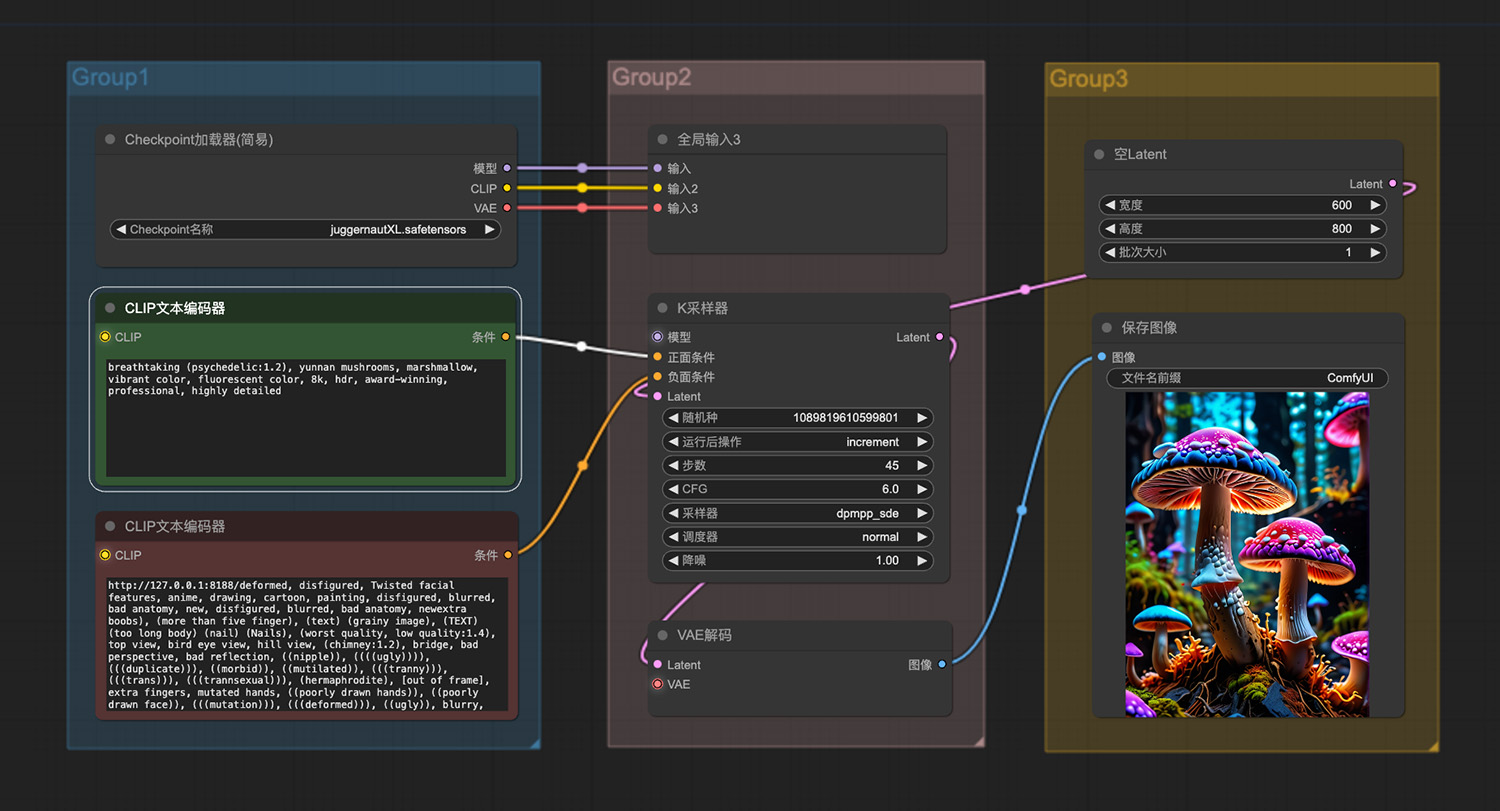 红伞伞蓝杆杆云南蘑菇群ComfyUI工作流
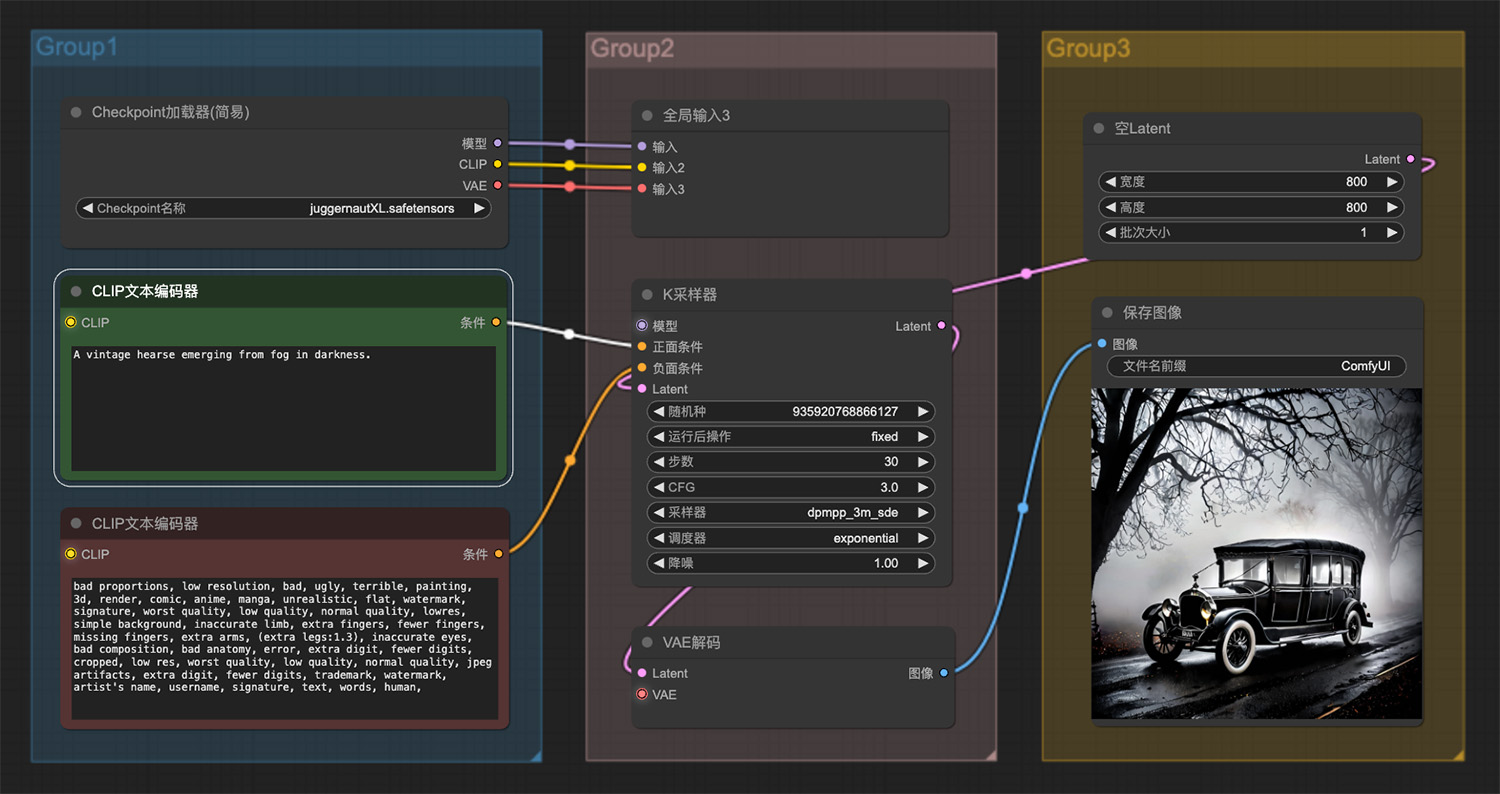 一辆老式灵车在黑暗中从雾中出现ComfyUI工作流
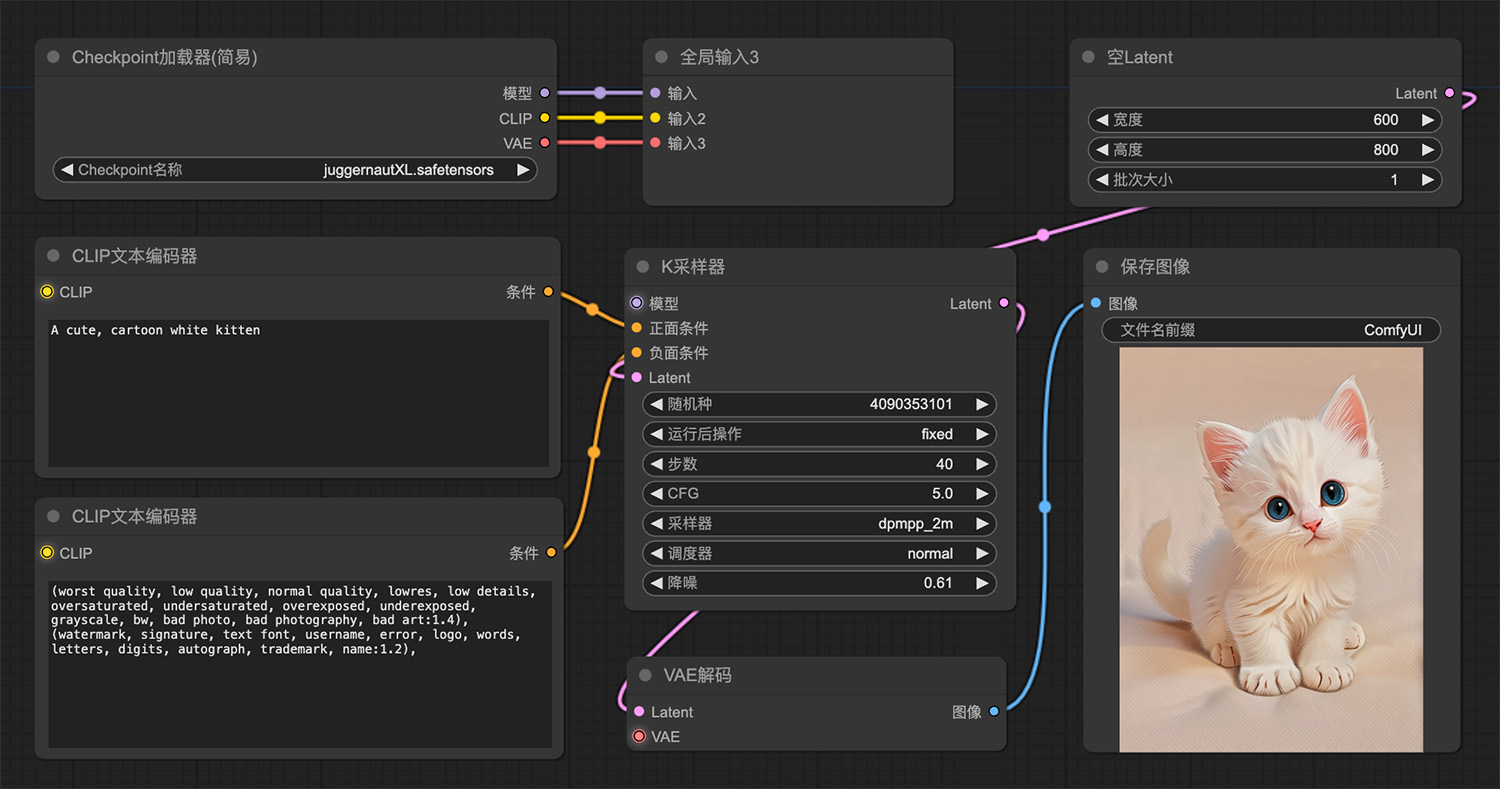 一只白色小猫comfyui工作流
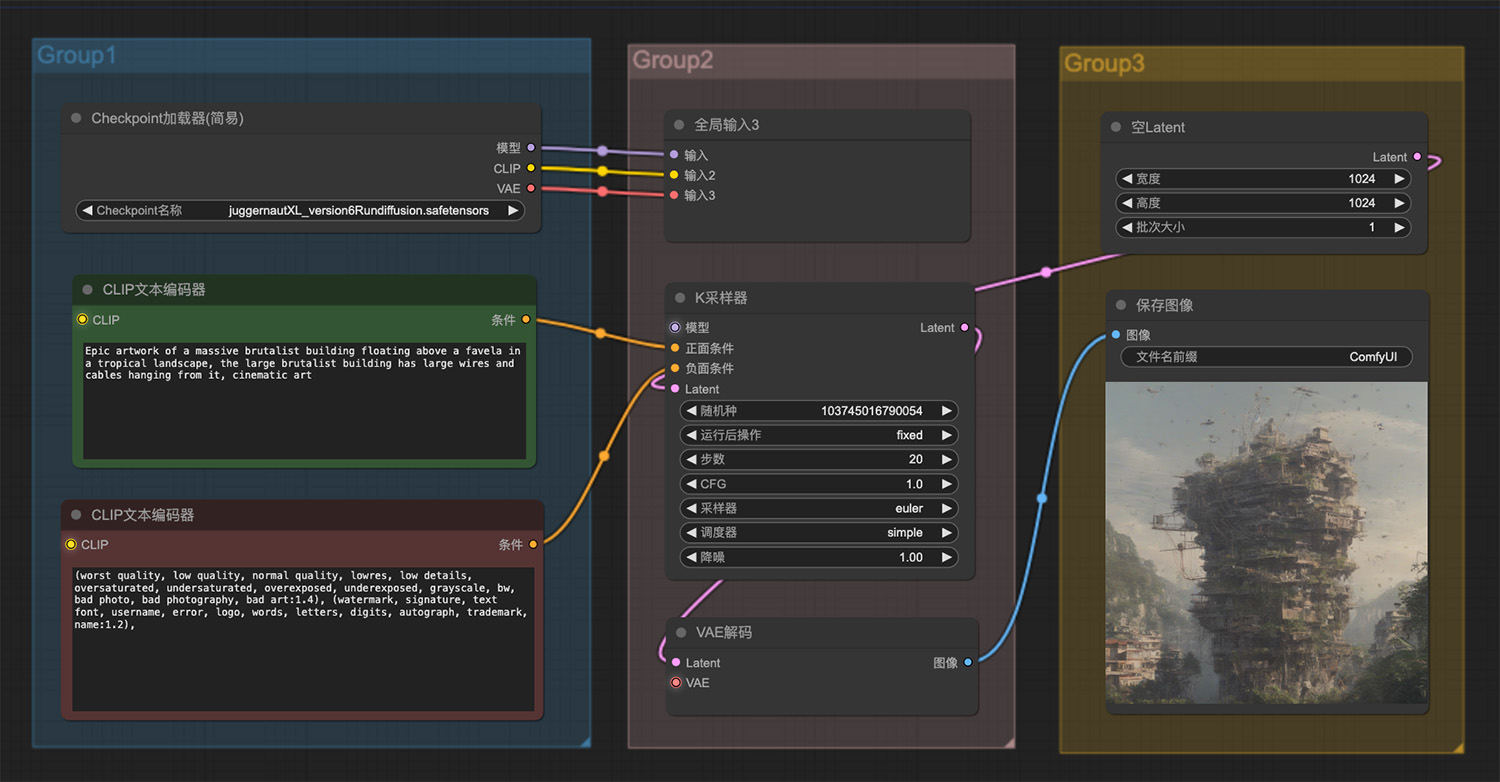 一座巨大的野兽派建筑漂浮在热带风景中的贫民
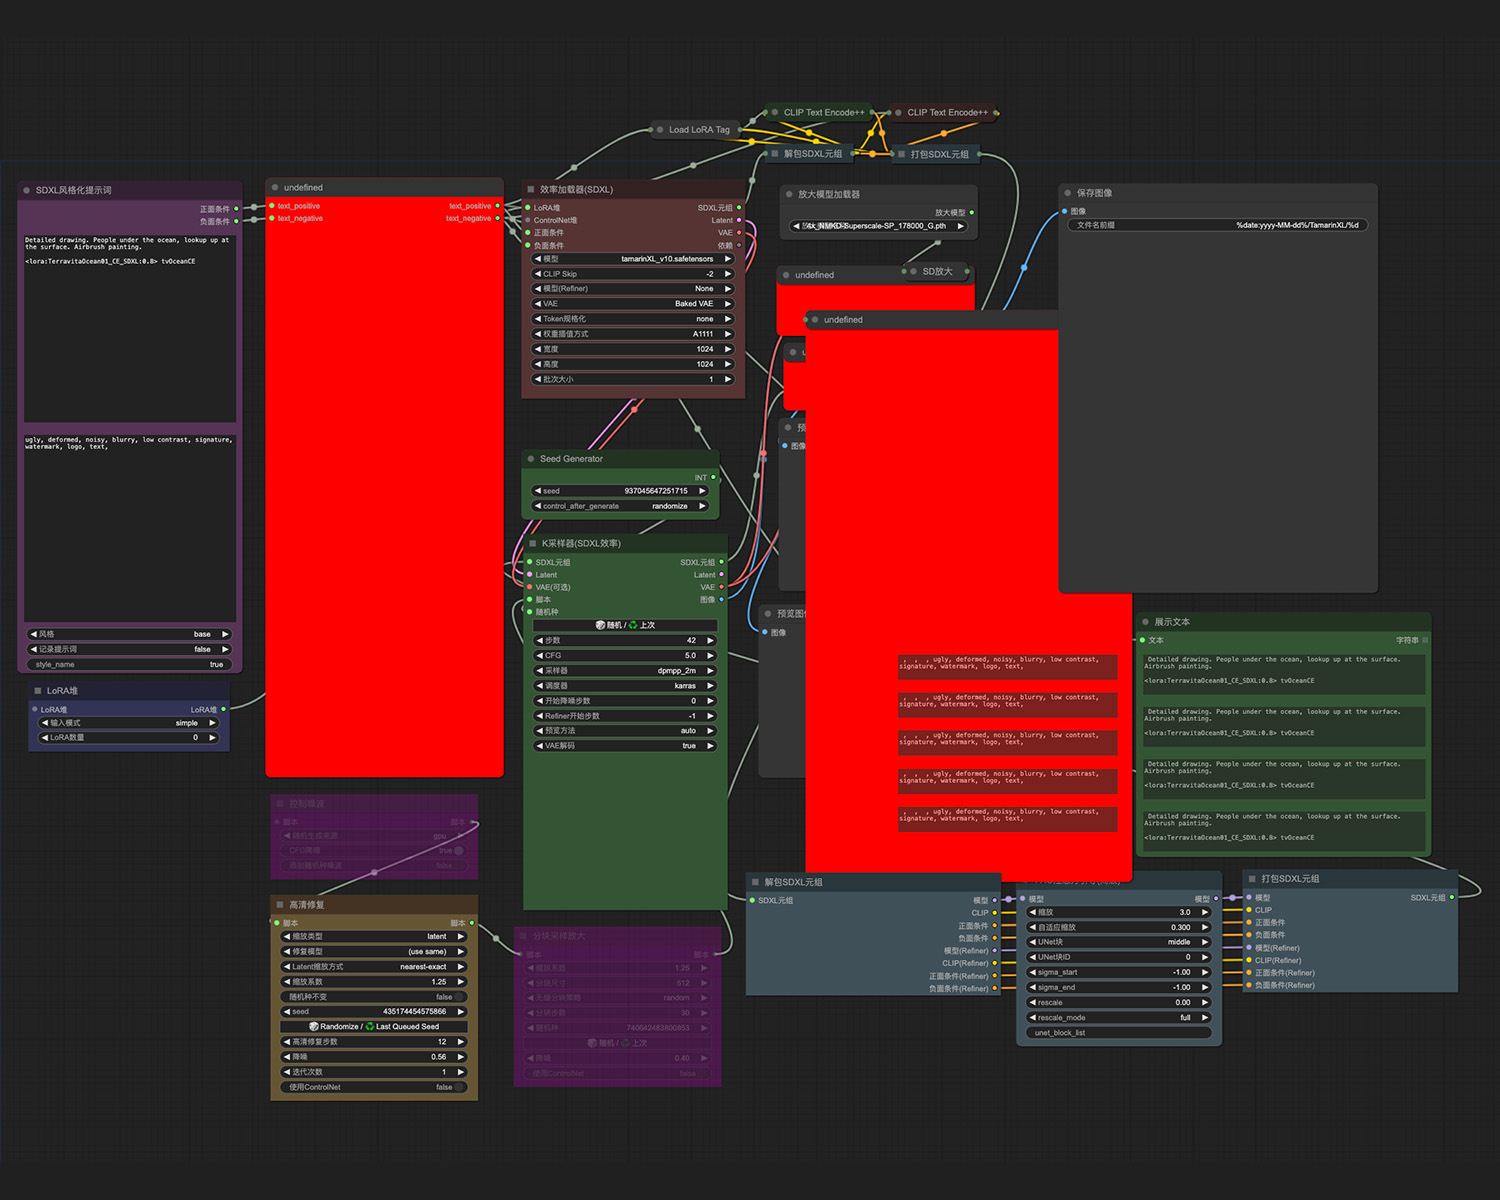 潜水员,珊瑚,鲸鱼,潜水艇comfyui工作流
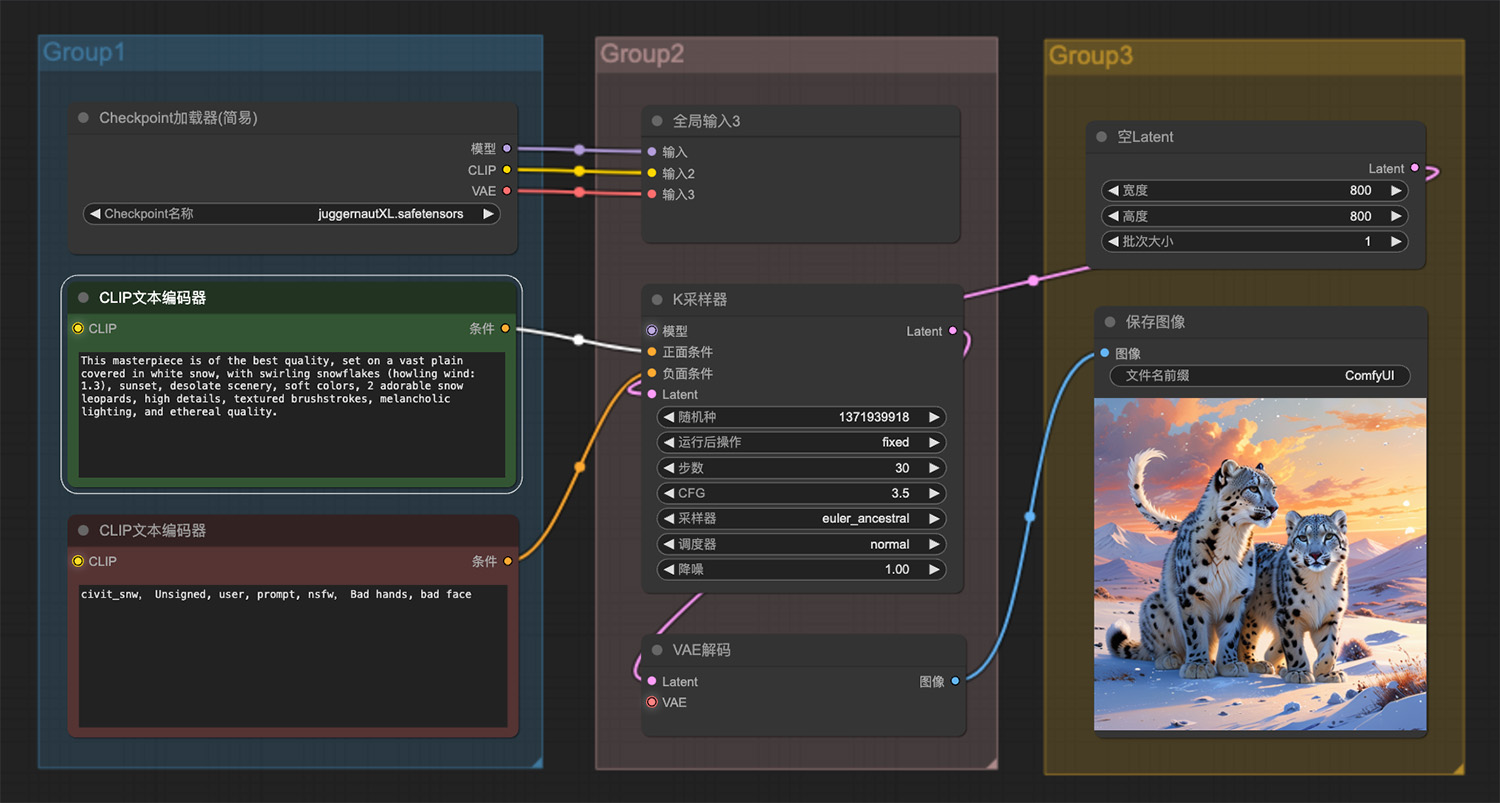 坐落在白雪覆盖的广阔平原上2只可爱的雪豹
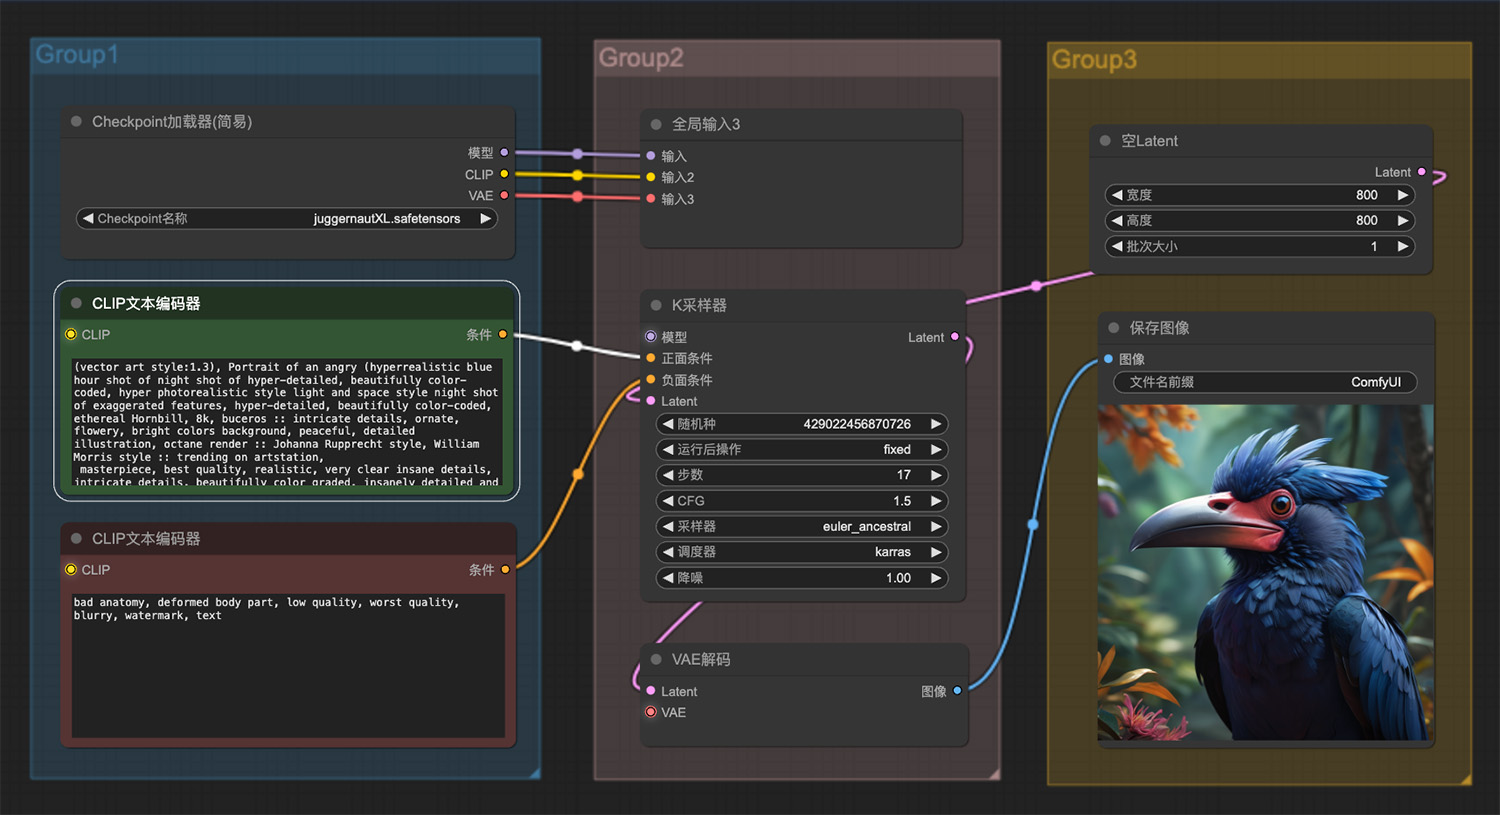 森林里一只空灵的犀鸟ComfyUI工作流