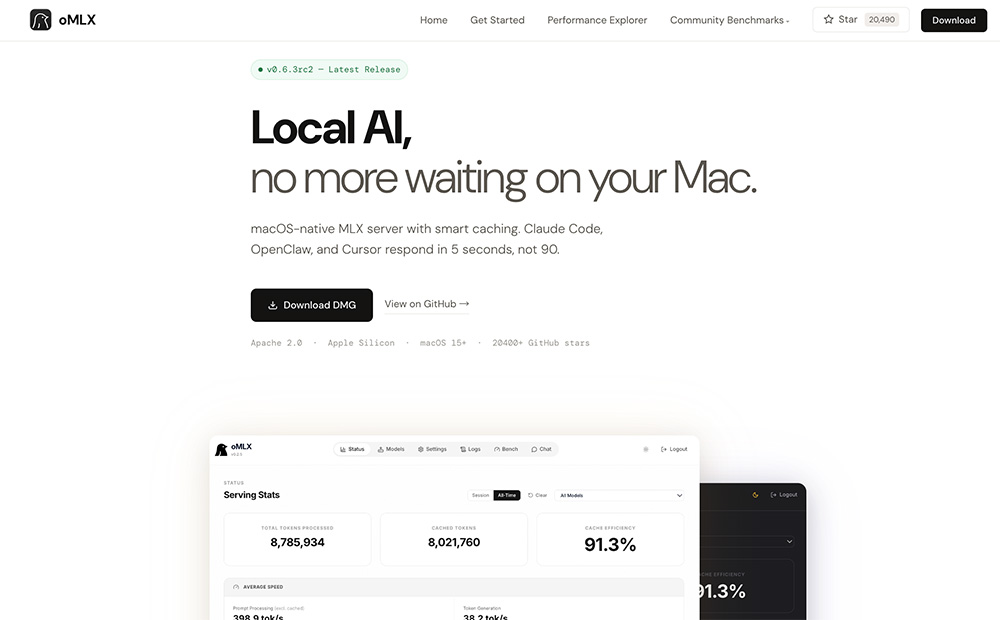
oMLX是基于Apple MLX框架打造的macOS原生本地AI推理服务器,专为Apple Silicon芯片优化,支持本地离线运行各类AI模型。通过分页式SSD KV缓存、连续批处理等硬件级优化,大幅提升本地推理速度与并发吞吐量;全面兼容OpenAI与Anthropic接口,支持多模型部署、工具调用与MCP集成,搭配系统菜单栏与网页控制台,为macOS用户提供高性能、轻量化、可私有化的本地AI推理方案。
一、产品核心功能:
1、SSD分页KV缓存加速:显著缩短编程智能体首Token生成耗时,大幅提升本地响应速度。
2、连续批处理调度:高效处理多并发请求,提升本地推理整体吞吐量。
3、双API协议兼容:原生支持OpenAI、Anthropic接口,无缝对接各类主流AI客户端。
4、多模型统一服务:支持大语言模型、视觉多模态模型、向量嵌入模型、重排序模型一站式部署。
5、工具调用与MCP集成:原生支持函数工具调用、MCP协议对接,适配智能体工作流本地调试。
6、双端可视化管理:搭载macOS原生菜单栏应用 + Web控制面板,支持模型管理、对话调试、实时性能指标监控。
7、生态模型兼容:支持Hugging Face标准MLX格式模型,资源生态丰富。
8、智能内存调度:内存不足时自动开启LRU模型淘汰机制,保障设备稳定运行。
9、缓存复用机制:自动兼容Hugging Face、LM Studio本地模型缓存,避免重复下载、节省存储空间。
二、典型使用案例:
1、在Apple Silicon设备运行本地编程智能体,实现低延迟、高响应的代码辅助开发。
2、将本地模型作为后端,对接Cursor、Claude Code、OpenClaw等主流AI客户端。
3、在macOS设备上同时部署、调度、服务多款本地大模型与视觉多模态模型。
4、基于本地兼容API,自主开发私有化AI应用、插件与服务。
5、完全离线本地环境,调试工具调用、MCP智能体工作流,无需依赖云端。
6、私有化运行本地对话、向量嵌入、文本重排序、多模态推理等任务,保障数据不外泄。
三、标准使用流程:
1、下载官方签名DMG安装包,拖拽安装至macOS应用程序目录。
2、配置本地模型存储目录,启动本地推理服务,选择或下载MLX格式模型。
3、也可通过Python3.10+环境,拉取源码手动安装,通过指令启动服务。
4、将Cursor、Claude Code等兼容客户端的接口地址指向本地oMLX服务端点。
5、通过网页控制台或菜单栏工具,管理模型、查看运行指标、调试对话与工作流。
数据统计
特别声明&浏览提醒
本站AI工具导航站提供的「oMLX」的相关内容都来源于网络,不保证外部链接的准确性和完整性。在2026年08月25日 05时33分30秒收录时,该网站上的内容都属于合规合法,后期网站的内容如出现违规,可以直接联系网站管理员(ai@ipkd.cn)进行删除,AI工具导航站不承担任何责任。在浏览网页时,请注意您的账号和财产安全,切勿轻信网上广告!
 盘点7款主流AI训练模型:技术特性与应用场景解析
 12款免费AI内容检测工具,助力改写提升原创度
 盘点打工人必备的几款业余追剧神器
 2025年ai声音克隆哪个最好 盘点值得推荐的AI声音克隆工具2025
 6款AI视频翻译与配音工具,一键生成多语言视频
 9款免费AI模特生成工具:个性化定制专属模特
 SkyGen Plus 一站式多模型 AI 内容创作平台
 5个免费AI漫画生成工具,一键开启漫画创作之旅!
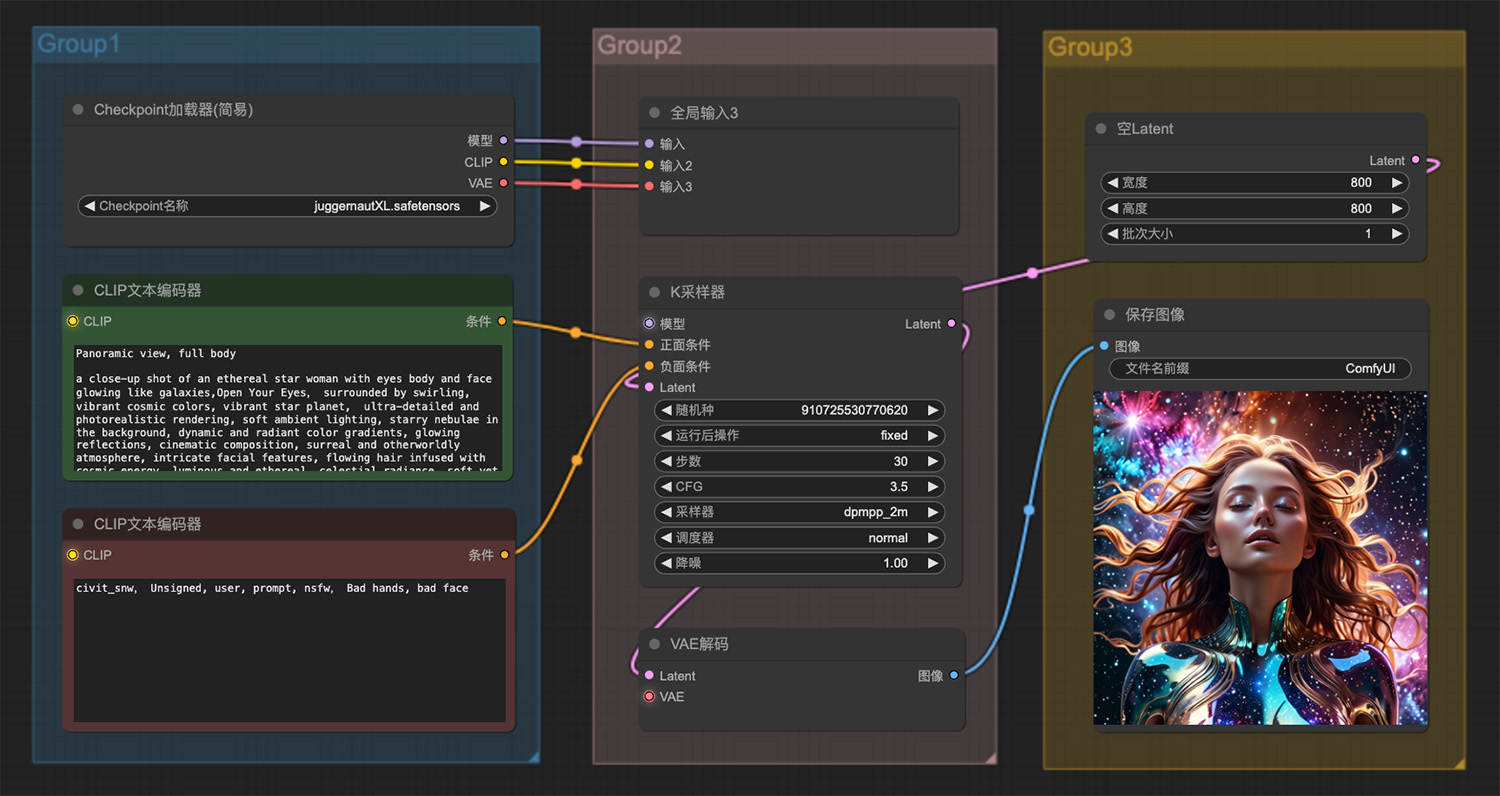 一个超凡脱俗的女明星的特写镜头ComfyUI工作流
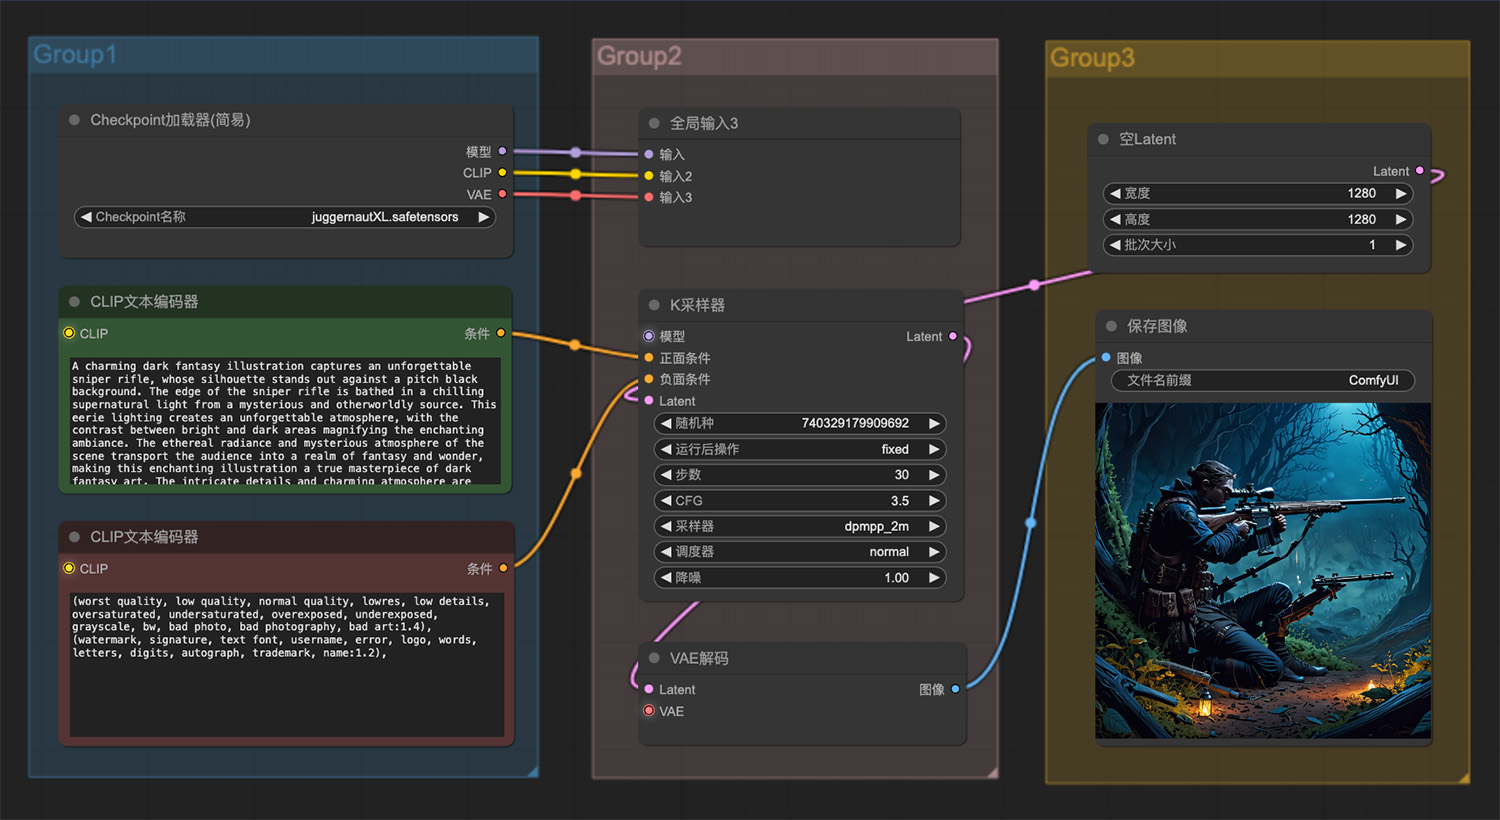 一支令人难忘的狙击步枪ComfyUI工作流
 一棵白色心形流苏树comfyui工作流
 一群邪恶的小黄人ComfyUI工作流
 一张科幻照片,火星车在沙漠里ComfyUI工作流
 一颗闪闪发光的水晶漂浮在森林里
 一位漂亮的女人坐在樱花树旁
 葡萄庄园白葡萄酒ComfyUI工作流
 藏族日历小程序
 KimiK3 ai
 Humalike
 Elements Claw
 GoogleAI学习课
 开发者搜索
 Datadog
 彝族日历小程序
 KerWork
 Qdrant
 TrustOSS
 扣子罗盘
 Page Agent