-
- AI商务助手
违禁词过滤AI过滤AI标签AI图像描述AI图像识别
Visionati平台对接OpenAI、Gemini、Claude、Grok、Amazon Rekognition、Replicate等多款AI模型,保障分析结果的准确度与信息深度,可将复杂的图像、视频视觉内容转化为清晰可落地的分析洞察。
爱站权重:
Visionati是一体化视觉AI分析平台,整合图像描述、详情说明、智能标签等多项能力。平台对接OpenAI、Gemini、Claude、Grok、Amazon Rekognition、Replicate等多款AI模型,保障分析结果的准确度与信息深度,可将复杂的图像、视频视觉内容转化为清晰可落地的分析洞察,服务数字营销、内容叙事、数据分析等业务场景。平台提供完整视觉分析工具集,支持图像标注、内容描述、智能打标以及内容过滤处理。
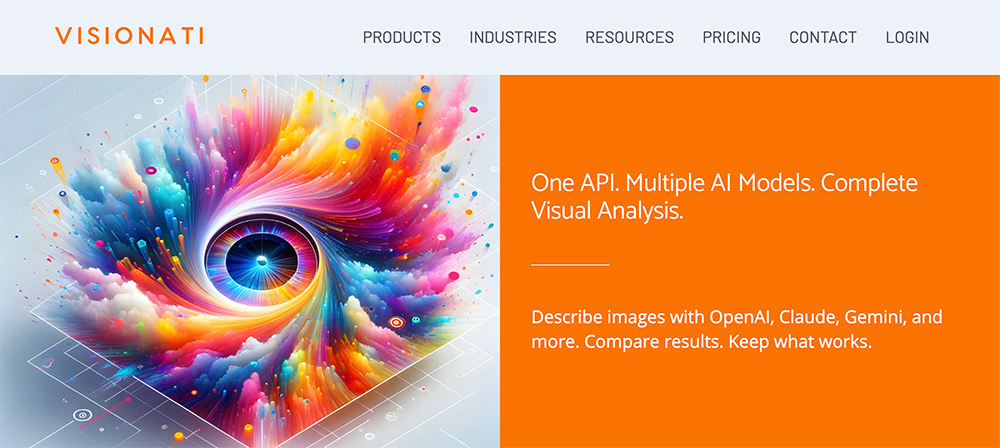
一、产品核心功能:
1、图像标注:识别图像内各类元素,自动生成标注信息。
2、详细描述:输出完整详实的图像文本说明,还原画面内容。
3、智能标签:基于画面内容自动生成配套标签,方便素材归类检索。
4、内容过滤:实现内容审核过滤,管控不适宜内容。
5、人脸识别:检测画面当中的人脸对象。
6、品牌与标识检测:识别画面内的品牌LOGO,用于市场数据采集。
7、视频分析:对视频逐帧开展视觉解析,完成视频内容分析。
二、典型使用场景:
1、借助AI图像标注与深度解析,完成图像素材的信息转化,挖掘内容价值。
2、对视频进行逐帧深度解析,提取视频画面当中的有效信息。
3、批量完成视觉素材标记归类,高效管理图片、视频资源库。
4、自动识别拦截敏感内容,完成NSFW不适宜内容检测与管控。
5、识别媒体素材中的品牌标识,采集数据,输出市场分析洞察。
三、标准使用流程:
1、使用平台内置内容分析器,完成图像标注、内容描述,获取图片与视频的深度解析结果。
2、开发者可调用Visionati API,执行高度自定义的高级视觉分析与图像描述任务。
3、将能力无缝集成至自有应用程序,强化产品的视觉理解能力。
数据统计
特别声明&浏览提醒
本站AI工具导航站提供的「Visionati」的相关内容都来源于网络,不保证外部链接的准确性和完整性。在2026年08月31日 07时14分11秒收录时,该网站上的内容都属于合规合法,后期网站的内容如出现违规,可以直接联系网站管理员(ai@ipkd.cn)进行删除,AI工具导航站不承担任何责任。在浏览网页时,请注意您的账号和财产安全,切勿轻信网上广告!
 CodeGraph – 面向AI编码代理的预索引代码知识图谱工具
 ClawHub镜像站官网:OpenClaw官方推出的中国区专属镜像站点
 7款免费AI英语口语软件,一对一模拟对话,轻松开口说英语!
 别再用PS啦!这7款AI修图神器,一键出大片!
 美客多全球6大国际站大盘点
 多款免费AI声音克隆工具,精准复刻音色,你也可以当主播
 2025年ai声音克隆哪个最好 盘点值得推荐的AI声音克隆工具2025
 几款AI虚拟伴侣社交软件,专属聊天与情感陪伴!
 一只蚊子被嵌在琥珀中ComfyUI工作流
 一只开屏的白色孔雀ComfyUI工作流
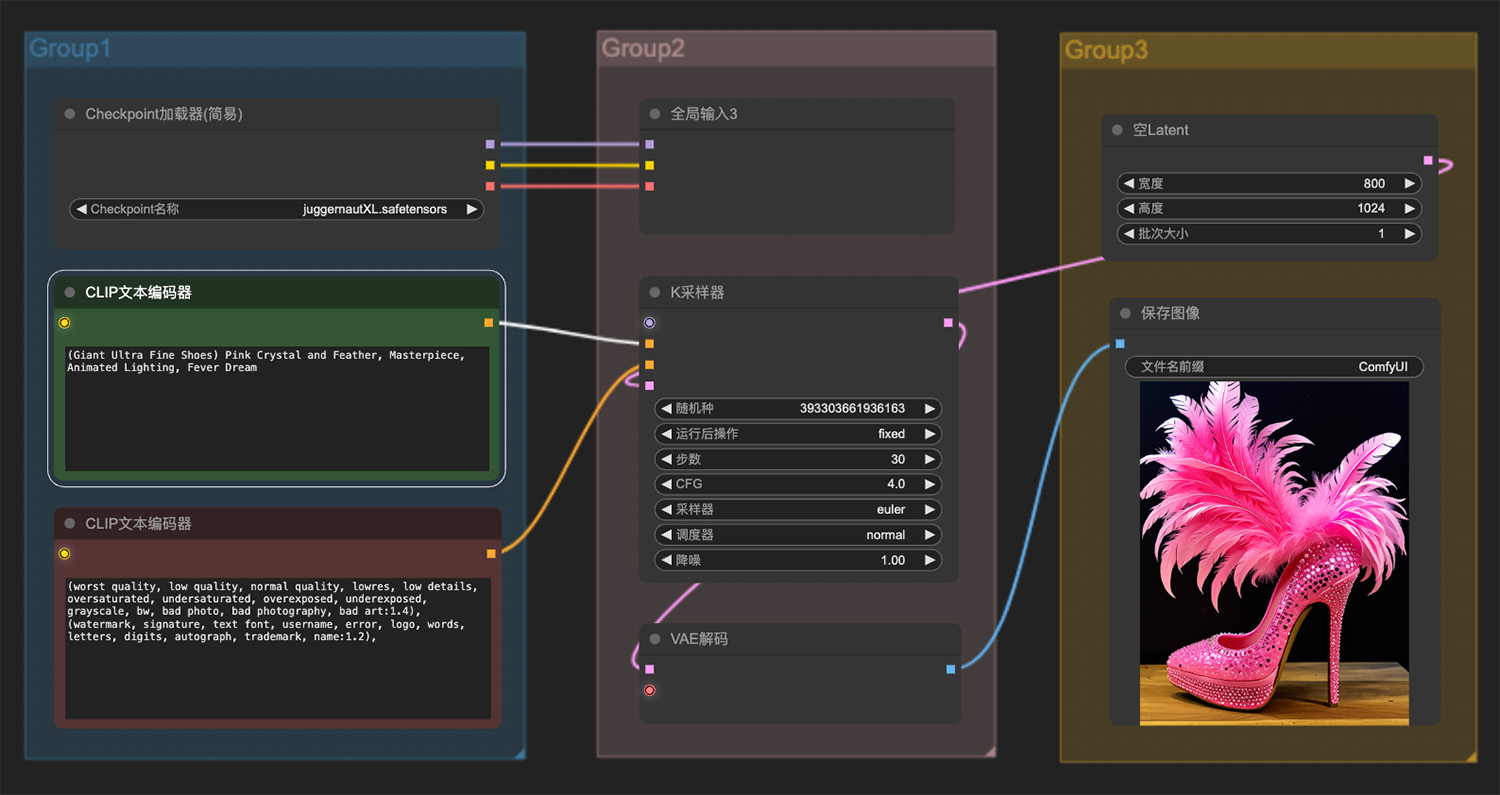 一只由粉色水晶与羽毛组成的巨型高跟鞋
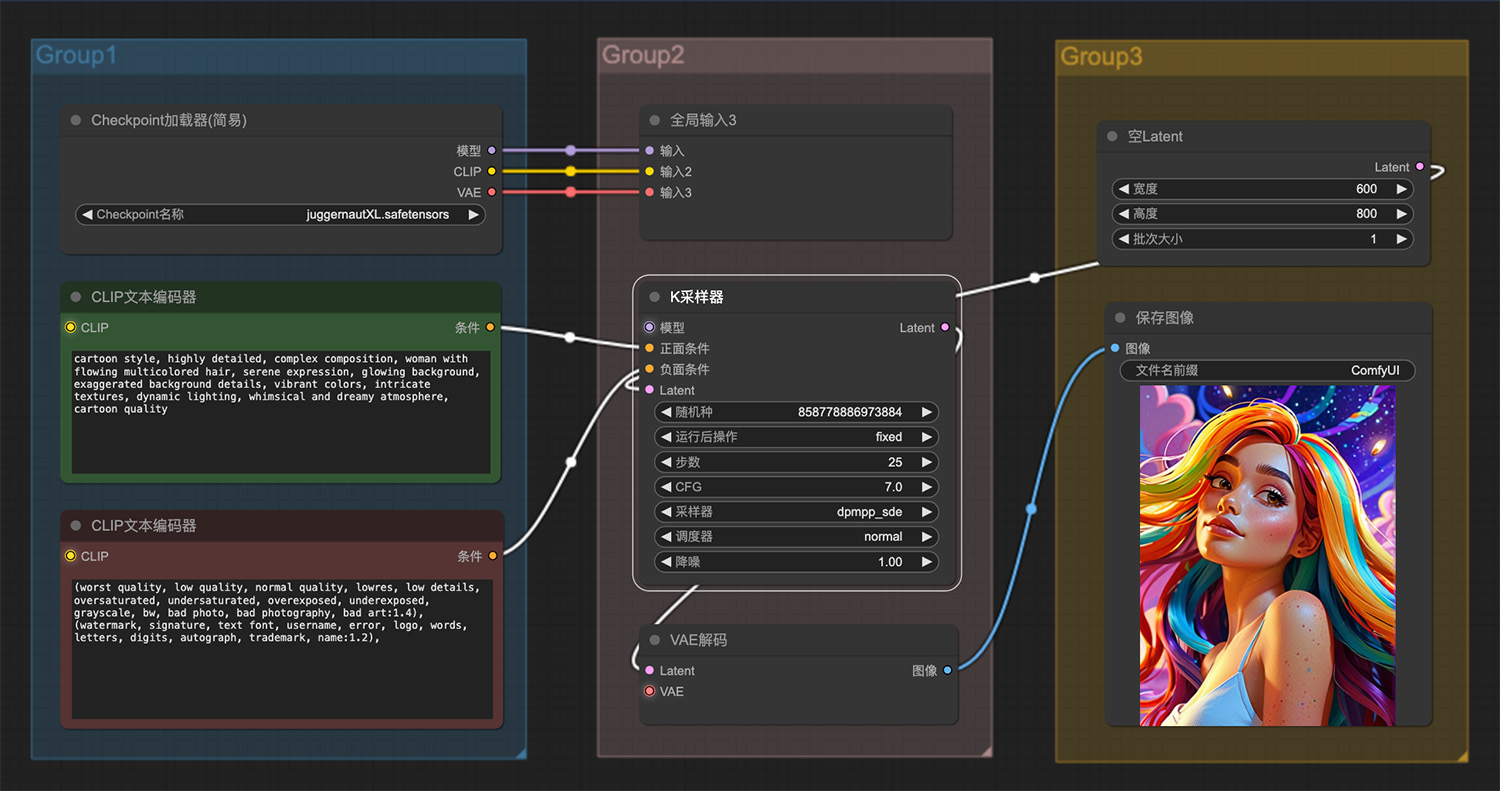 3d卡通风格多彩头发的女人
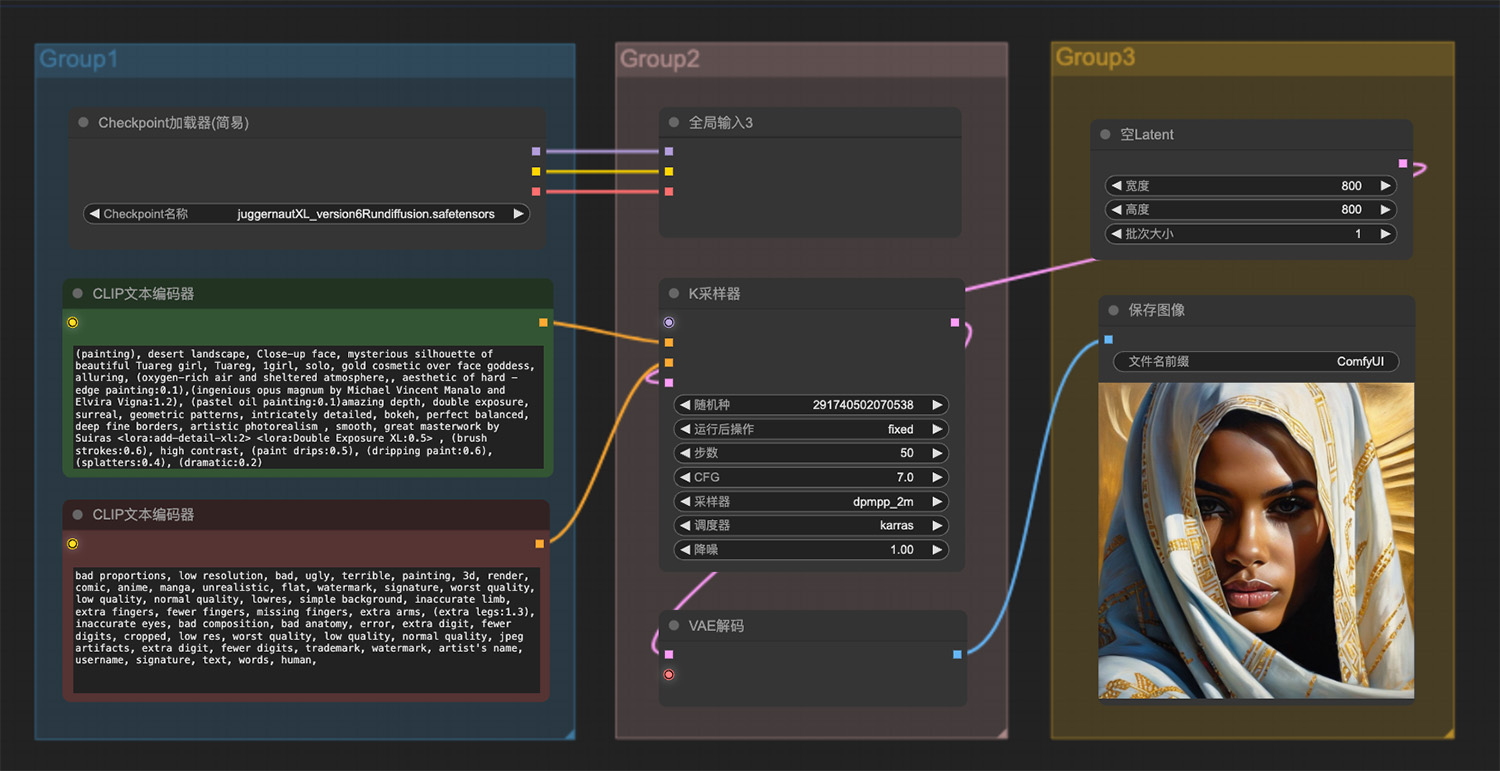 沙漠里美丽的图阿雷格女孩ComfyUI工作流
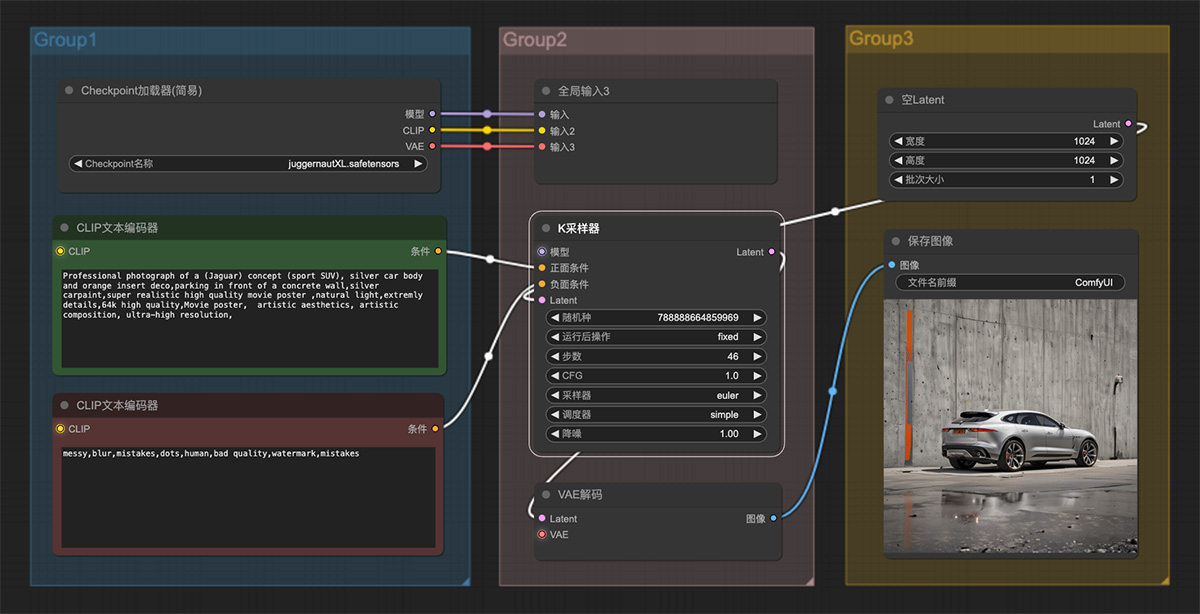 一辆停在混凝土墙前运动型SUV捷豹概念车
 一只竹节虫ComfyUI工作流
 广阔的沙漠中矗立着一个生锈的巨大头盔
 藏族日历小程序
 Bertha.ai
 UserWatch
 nashnova
 FetchrLy
 Avoma
 ShowIn AI
 彝族日历小程序
 Omneky
 StockInsights AI
 ShopOS
 Seymour Events