 博查万象
 Portkey
 CC Switch
 Xiaomi Miloco 2.0
 Mavis
 Corrath
Obscura是面向AI智能体与网页自动化场景的开源无头浏览器,基于Rust语言构建。摒弃Chromium臃肿架构,依靠轻量化独立引擎完成网页渲染与JavaScript执行,能够以极低资源开销实现隐蔽、高速的网页访问与页面操作。可作为Chrome的轻量化替代,原生兼容Puppeteer、Playwright生态,支持MCP协议,可直接对接Claude、Cursor等AI工作流,充当大模型访问互联网的桥梁。
一、产品核心功能:
1、无头网页抓取:
通过命令行或者API完成网页拉取渲染,提取页面文本、链接、HTML以及各类原始资源。
2、AI Agent浏览器能力:
内置MCP服务器,支持Claude、Cursor等AI直接执行页面浏览、截图、表单填写、JS脚本运行等浏览器操作。
3、原生渲染导出:
不依赖Chromium,支持PNG截图、PDF导出,提供CDP录屏流输出。
4、Stealth隐身反检测:
一键开启隐身模式,自动随机化浏览器指纹,拦截3500+网页跟踪器,降低被站点反爬识别概率。
5、并发批量抓取:
基于worker进程实现多URL并行处理,支持JSON格式输出,支持自定义内容提取逻辑。
6、CDP协议生态兼容:
完整实现CDP协议,可直接替换接入Puppeteer、Playwright,现有项目迁移改动量小。
二、典型使用场景:
1、AI智能体通过MCP调用浏览器,自动完成网页浏览、信息检索、表单提交等自动化任务。
2、低资源服务器环境下大规模无头网页采集,提取网页文本、链接、HTML素材。
3、自动化网页截图、PDF导出、页面录屏,批量产出网页快照资源。
4、需要规避反爬策略,开展隐身模式下的网页数据采集工作。
5、现有Puppeteer、Playwright项目,替换Chromium,降低内存与硬件资源消耗。
6、批量并发抓取大量网页,输出结构化JSON数据用于后续业务处理。
三、标准使用流程:
1、从GitHub Releases下载对应系统版本压缩包并解压,无需预先部署Chrome、Node.js等外部组件。
2、单页面抓取:执行obscura fetch 'URL'获取页面,搭配--dump html/text/links参数输出HTML、文本、链接等目标内容。
3、CDP服务启动:执行obscura serve --port 9222启动CDP服务,Puppeteer、Playwright可直接连接该服务替代Chrome。
4、启用隐身模式:在命令行追加--stealth参数,自动完成指纹随机化、跟踪器拦截。
5、批量并发采集:执行obscura scrape url1 url2 --concurrency 25,多链接并行抓取,输出JSON结果。
6、AI Agent对接:运行obscura mcp启动MCP服务,Claude、Cursor等AI工具即可调用浏览器完成各类网页自动化任务。
数据统计
特别声明&浏览提醒
本站AI工具导航站提供的「Obscura」的相关内容都来源于网络,不保证外部链接的准确性和完整性。在2026年09月07日 08时14分43秒收录时,该网站上的内容都属于合规合法,后期网站的内容如出现违规,可以直接联系网站管理员(ai@ipkd.cn)进行删除,AI工具导航站不承担任何责任。在浏览网页时,请注意您的账号和财产安全,切勿轻信网上广告!
 6款热门AI图片生成工具,国内外智能创作神器!
 美客多全球6大国际站大盘点
 互联网最火的10个大语言模型及其应用场景全解析
 11款免费AI简历生成工具,轻松打造专业求职简历
 11款免费AI思维导图工具,一键生成高效思维图
 GLM-5V-Turbo基座模型官网 - 智谱AI推出的原生多模态Coding基座模型
 8款AI照片优化修复AI工具大盘点
 几款免费AI视频转动漫神器,一键生成超酷动画片!
 令人着迷的一只老虎ComfyUI工作流
 一只躲在一堆秋叶里的小刺猬
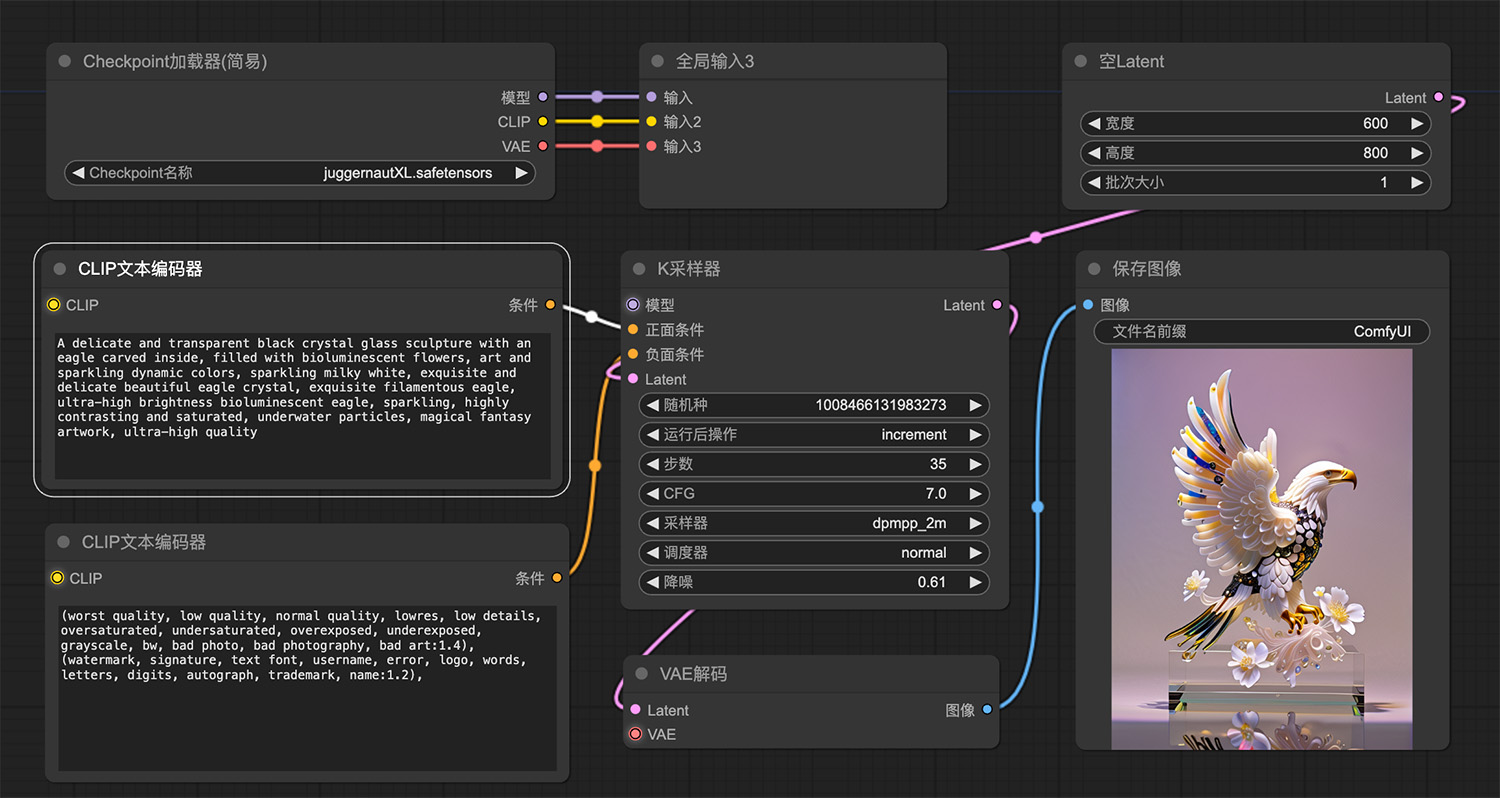 彩色雄鹰玉雕ComfyUI工作流
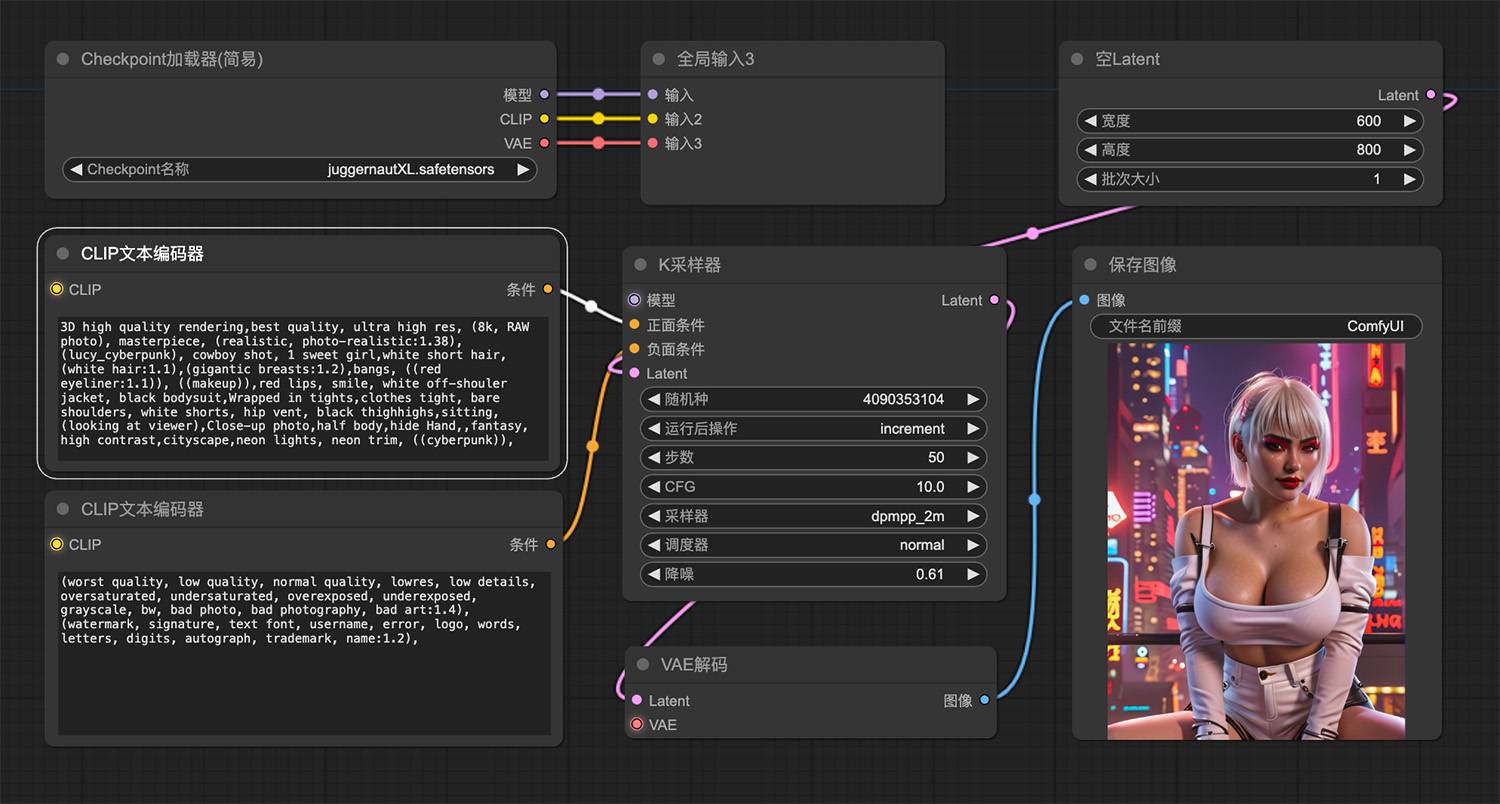 1个可爱的白色短发女孩
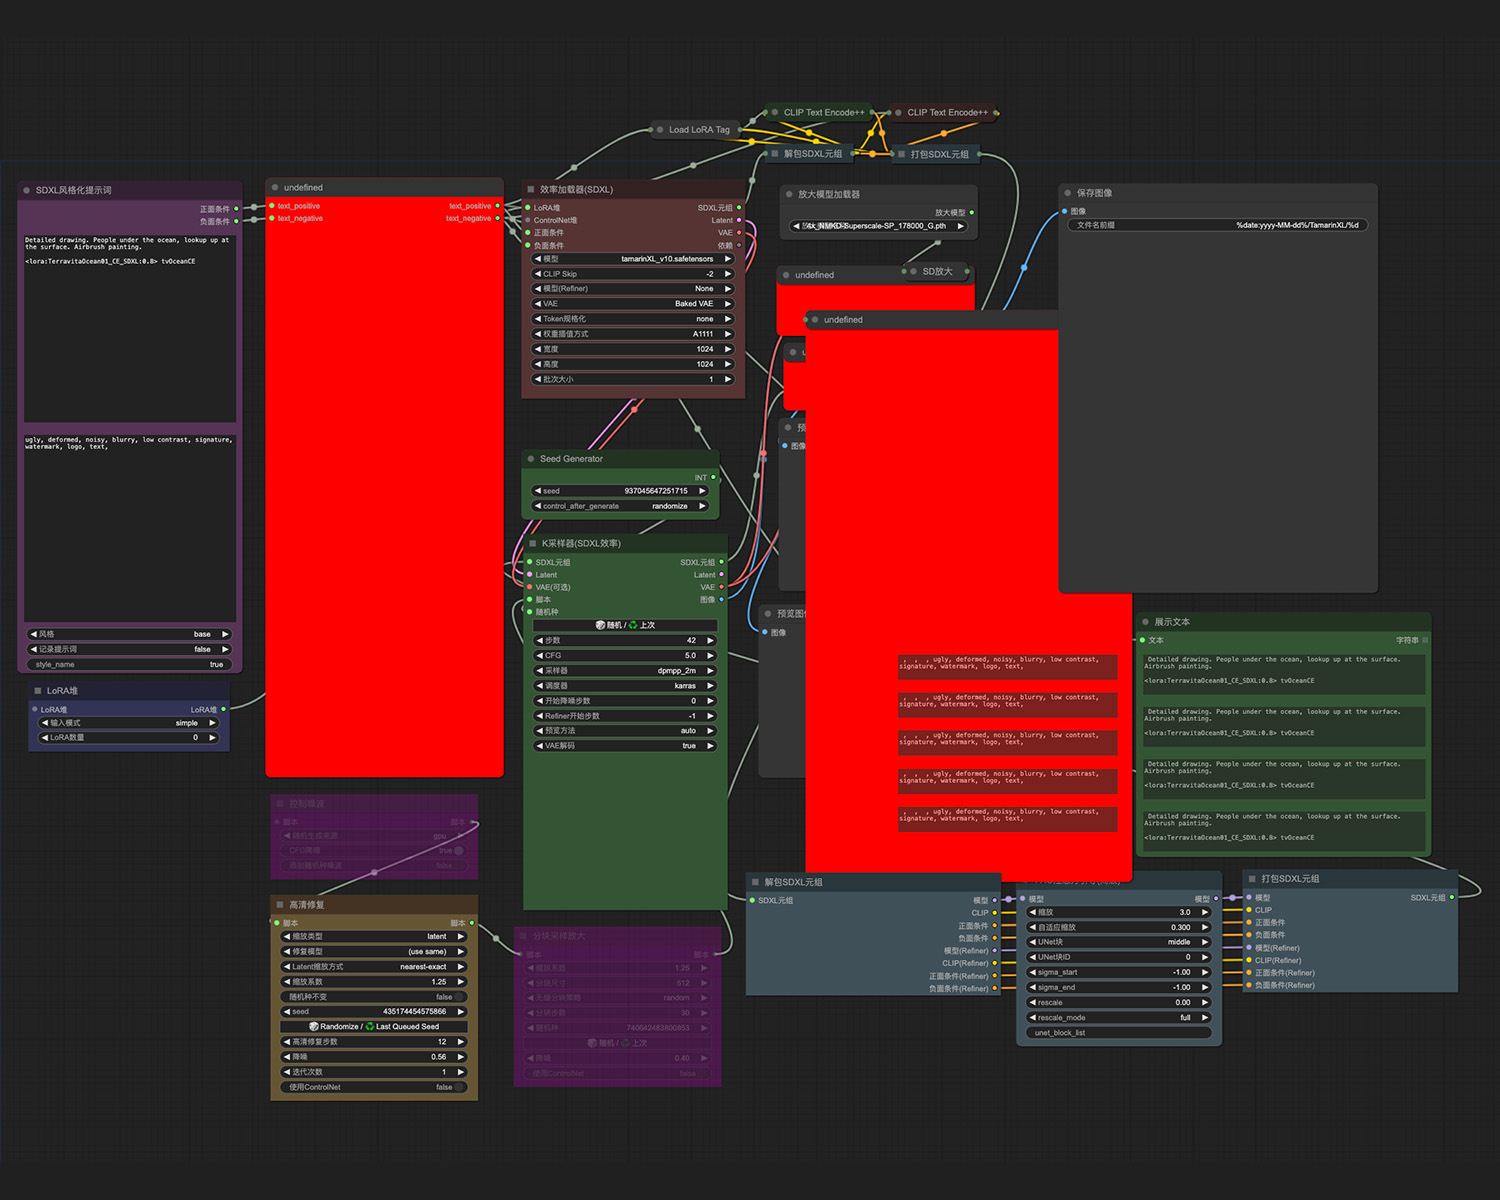 潜水员,珊瑚,鲸鱼,潜水艇comfyui工作流
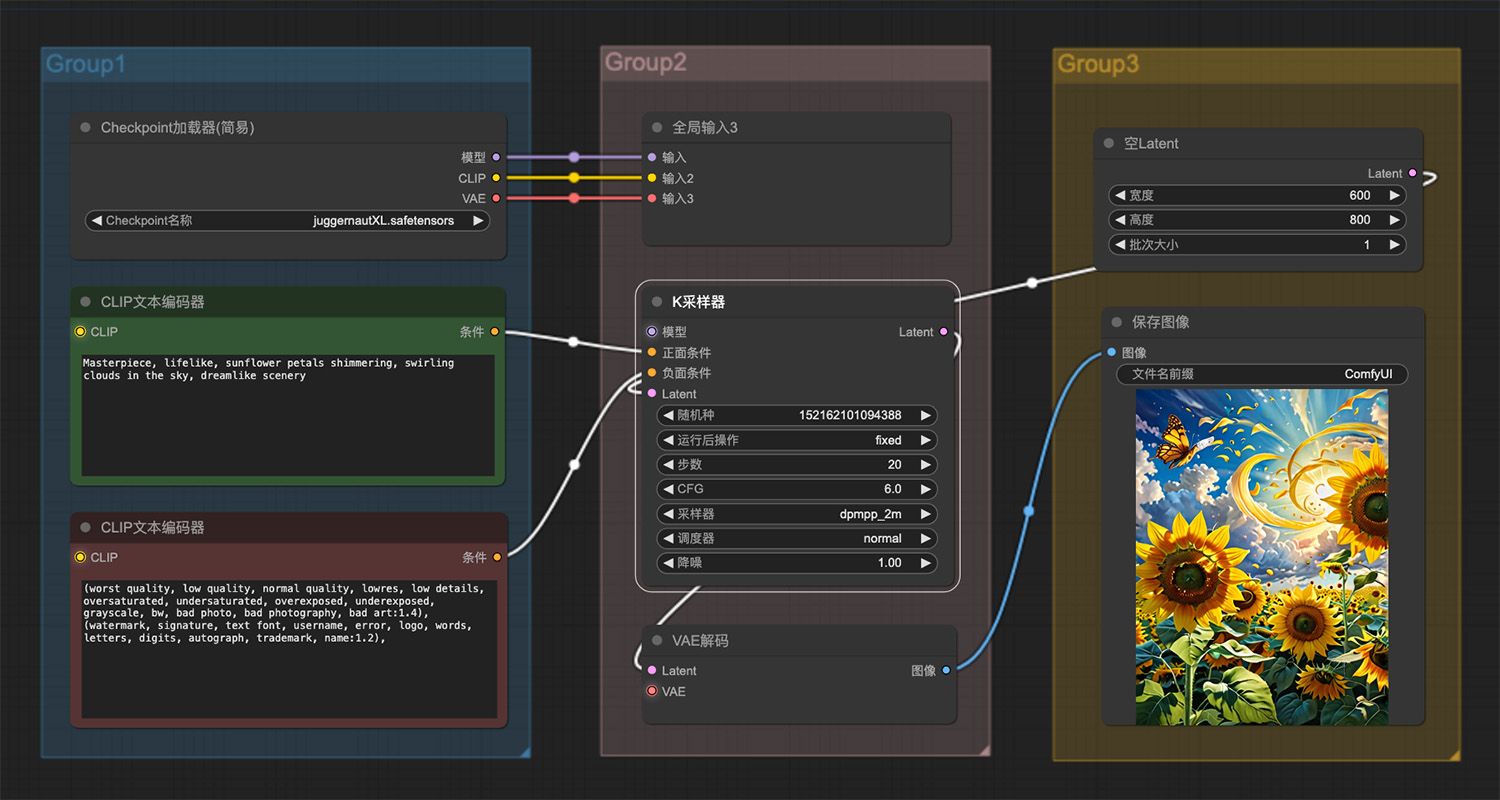 梦幻向日葵ComfyUI工作流
 一张科幻照片,火星车在沙漠里ComfyUI工作流
 一个超凡脱俗的女明星的特写镜头ComfyUI工作流