-
- AI开发助手
GPT工具模型阿里QwenAI模型广场AI推理模型MoE大模型
FreeToken系统通过全层双缓冲、带宽自适应混合调度、Agent状态复用及弹性显存热扩缩容等技术,将个人电脑的CPU、内存、PCIe与GPU统一为弹性计算平台。
爱站权重:
FreeToken是UC Berkeley与MIT等机构联合开源的端侧MoE大模型推理系统。系统通过全层双缓冲、带宽自适应混合调度、Agent状态复用及弹性显存热扩缩容等技术,将个人电脑的CPU、内存、PCIe与GPU统一为弹性计算平台,实现单卡消费级硬件满血运行Qwen3.6-35B、DeepSeek-V4-Flash 284B等超大MoE模型,让本地部署顶尖AI成为现实。
一、产品核心功能:
1、端侧满血推理:
支持在RTX 4060/5090等消费级单卡上满血运行Qwen3.6-35B、DeepSeek-V4-Flash 284B等超大MoE模型。
2、全层双缓冲预取:
GPU计算当前层时,后台通过PCIe流式预取下一层Expert权重,彻底消除I/O等待气泡。
3、带宽自适应调度:
实时探测PCIe带宽与CPU算力,动态分流未命中Expert至GPU缓存或CPU就地计算,拉到硬件吞吐极限。
4、Agent状态复用:
在特殊Token边界设置轻量检查点,上下文编辑时仅从最近锚点增量Prefill,避免重复计算完整历史。
5、弹性显存热扩缩:
后台应用抢占显存时,无缝收缩GPU Cache并转交CPU计算,实现0停机、不OOM的平滑降级。
6、极速低延迟:
首Token延迟降低42–58%,Agent多轮交互TTFT减少65–80%,整体比Ollama快2–4倍。
二、产品核心优势:
1、打破硬件门槛:
消费级单卡(如RTX 4060/5090)即可满血运行35B–753B参数的超大MoE模型,无需数据中心集群。
2、推理速度领先:
比Ollama快2–4倍,比llama.cpp快1.46倍,笔记本RTX 4060跑Qwen3.6-35B可达39.3 tok/s。
3、首Token延迟极低:
通过全层双缓冲与带宽自适应调度,将长Prompt的TTFT降低42–58%。
4、Agent交互优化:
基于Token边界轻量检查点与状态复用,多轮工具调用场景的TTFT减少65–80%。
5、弹性显存不崩溃:
后台应用抢占显存时,可热扩缩GPU Cache并转交CPU计算,实现0停机、不OOM的平滑降级。
6、全栈异构协同:
将CPU、系统内存、PCIe总线与GPU统一为弹性推理平台,自动收敛至硬件拓扑的理论最大吞吐。
三、标准使用流程:
1、桌面App安装:
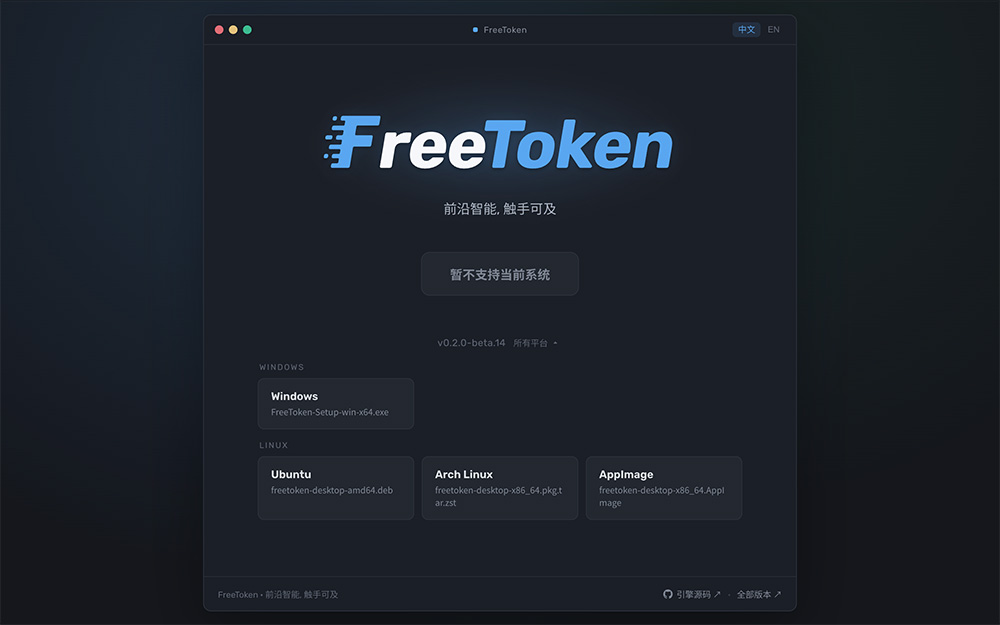
访问FreeToken官网https://www.flashml.ai/ 下载Windows或Linux桌面App,安装后通过GUI界面即可启动推理服务。
2、命令行快速安装:
通过命令行执行uv pip install "freetoken[accel]" 一键完成CLI工具的安装。
3、模型载入与自动调度:
载入支持的MoE模型权重,系统会自动完成CPU-GPU异构调度与带宽自适应配置。
4、硬件配置建议:
运行DeepSeek-V4-Flash等超大模型时,建议配备32GB显存并搭配192GB以上内存保证稳定流畅。
5、弹性显存自动管理:
使用过程中若后台有游戏或渲染抢占显存,FreeToken会自动热扩缩容,无需手动干预或重启服务。
数据统计
特别声明&浏览提醒
本站AI工具导航站提供的「FreeToken」的相关内容都来源于网络,不保证外部链接的准确性和完整性。在2026年08月25日 06时41分52秒收录时,该网站上的内容都属于合规合法,后期网站的内容如出现违规,可以直接联系网站管理员(ai@ipkd.cn)进行删除,AI工具导航站不承担任何责任。在浏览网页时,请注意您的账号和财产安全,切勿轻信网上广告!
AI工具
 Mega-ASR – 面向全场景的高鲁棒语音识别基座模型
 5款AI老照片修复工具,轻松去除图片和视频马赛克
 盘点8款高效AI搜索工具,助力智能信息检索
 11款免费AI简历生成工具,轻松打造专业求职简历
 9款免费AI论文写作工具,高效助力学术创作
 美客多全球6大国际站大盘点
 6款AI视频翻译与配音工具,一键生成多语言视频
 11款热门AI音乐生成工具,国内外免费资源大推荐!
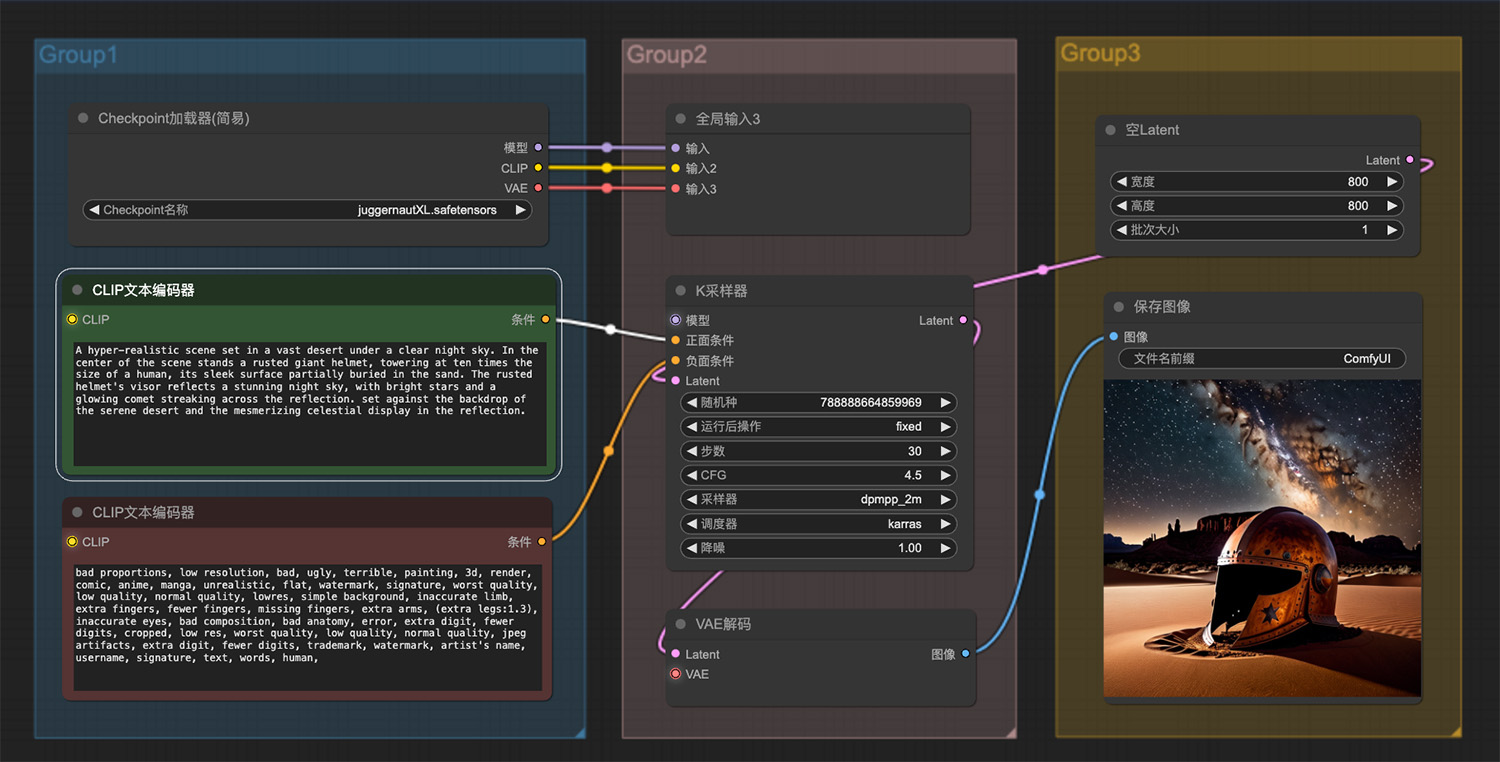 广阔的沙漠中矗立着一个生锈的巨大头盔
 一张精心制作的熊岛复古地图ComfyUI工作流
 一只处于战斗状态下的蚂蚁ComfyUI工作流
 王家卫电视剧繁花海报效果comfyui工作流
 金属埃及人ComfyUI工作流
 冬天的严寒里红梅枝上停留着一只鸟
 嘴唇丰满的漂亮女人
 一架令人难忘的美丽钢琴ComfyUI工作流
 藏族日历小程序
 RunInfra
 Sinew Design
 CodeMote
 GoogleAI学习课
 FlutterFlow
 Meteron AI
生活小工具
收录了万年历、老黄历、八字智能排盘等100+款小工具!
相关导航
 彝族日历小程序
 EmbedAPI
 WorldClaw
 QwenPaw
 Loopit
 跃迁维度
热门标签
100年美国总统选举各州分析图 2026年择吉老黄历 八字取名 2026年彝族日历 周公解梦大师 兼职平台AI PPT生成AI自动配图AI专辑封面生成器AI游戏AI和弦Python数据建模AI办公效率阿里云盘AI视频处理