
ForgeStencil由面壁智能联合OpenBMB开源社区推出,是全球首个实现Stencil自动研究、自动部署的端到端AI优化系统。依托Kernel Agent与App Agent双智能体闭环架构,全程零人工介入,自动完成优化策略探索、高性能算子合成、工程适配与生产级集成验证。
系统仅用一周时间,全自动完成 100余款工业与科学计算软件的深度优化,整体端到端中位加速比达1.41倍,广泛覆盖油气勘探、电磁仿真、医学影像等 8大工业领域、5大科学领域,彻底革新传统HPC人工调优范式。
一、产品核心功能:
1、双智能体闭环自主优化:
Kernel Agent 自主研究、迭代、合成高性能 CUDA 计算内核;App Agent 自动完成工程热点定位、算子替换锻造、精度正确性校验、生产代码无缝集成,形成全链路自动化闭环。
2、开放式优化策略探索:
跳出固定参数搜索框架,智能自主探索分块、数据融合、内存布局、占用率调优、主机端代码重构等多维优化策略,创新迭代最优加速方案。
3、生产级真实场景优化:
不以简易基准测试为目标,直接面向线上生产软件调优,以应用原生GPU代码为基线做真实端到端性能验证,优化效果可直接落地投产。
4、可审计可信测量协议:
通过统一环境开关交错切换原始程序与优化程序,依托程序原生校验逻辑与计时器统计数据,杜绝虚标,保障加速结果真实、可复现、可审计。
5、多代GPU自适应兼容:
原生支持 A100、H100、B200 等主流NVIDIA架构,运行时智能分发适配内核,同一代码库自动匹配对应硬件的最优执行路径。
二、产品核心优势:
1、全流程零人工干预:
从应用分析、热点挖掘、内核锻造、代码集成到正确性回归验证,全程AI自主完成,无需HPC高性能计算专家介入。
2、真实工业场景落地:
聚焦生产级商用软件优化,其中 42% 为真实工业投产软件,全部以业务原生GPU代码为基线,优化价值实打实。
3、研发效率量级跃升:
传统单应用人工调优需数月周期,系统可压缩至单日完成;一周落地百款应用,等效节省 20–30 人年研发人力投入。
4、优化性能强劲稳定:
全网端到端中位加速 1.41 倍,43% 应用加速 ≥1.5 倍,算子级几何平均性能较最优开源基线提升 2.16 倍。
5、跨硬件可持续迭代:
适配多代NVIDIA GPU架构迭代,硬件升级后可自动重锻内核、适配新硬件特性,长期保持最优性能水位。
三、标准使用流程:
1、环境准备:
克隆项目仓库,部署适配环境,需配备 NVIDIA GPU(A100 验证通过)、CUDA 12.x、C++17 编译器及 Python 3.9+ 运行环境。
2、快速算子体验:
执行一键测试命令,一分钟内完成单算子性能评测,并自动与 Halide 基线进行横向性能对比。
3、端到端工程复现:
进入目标应用目录,执行脚本拉取上游官方源码,自动应用集成补丁,运行验证脚本完成真实业务级全链路测试。
4、启动双智能体自主优化:
参照官方文档配置参数,启动 Kernel Agent、App Agent,开启全自动闭环优化迭代。
5、查看审计结果:
通过项目注册表文件,查阅全部100款已验证应用的审计记录、精准加速比与优化数据。
数据统计
特别声明&浏览提醒
本站AI工具导航站提供的「ForgeStencil」的相关内容都来源于网络,不保证外部链接的准确性和完整性。在2026年08月05日 08时09分26秒收录时,该网站上的内容都属于合规合法,后期网站的内容如出现违规,可以直接联系网站管理员(ai@ipkd.cn)进行删除,AI工具导航站不承担任何责任。在浏览网页时,请注意您的账号和财产安全,切勿轻信网上广告!
 10款AI换脸工具,一键变身,轻松玩转创意视频
 5个免费AI漫画生成工具,一键开启漫画创作之旅!
 12款AI生成PPT的工具和网站,快速打造精美演示文稿
 11款热门AI音乐生成工具,国内外免费资源大推荐!
 免费AI数据分析神器:一键生成可视化图表,轻松搞定复杂数据
 HiCAD – 专为3D打印爱好者打造的开源AI参数化3D CAD建模平台
 几款免费AI小说生成工具,轻松开启创作之旅!
 8款免费AI虚拟试衣工具,一键在线试穿,轻松搞定服装搭配!
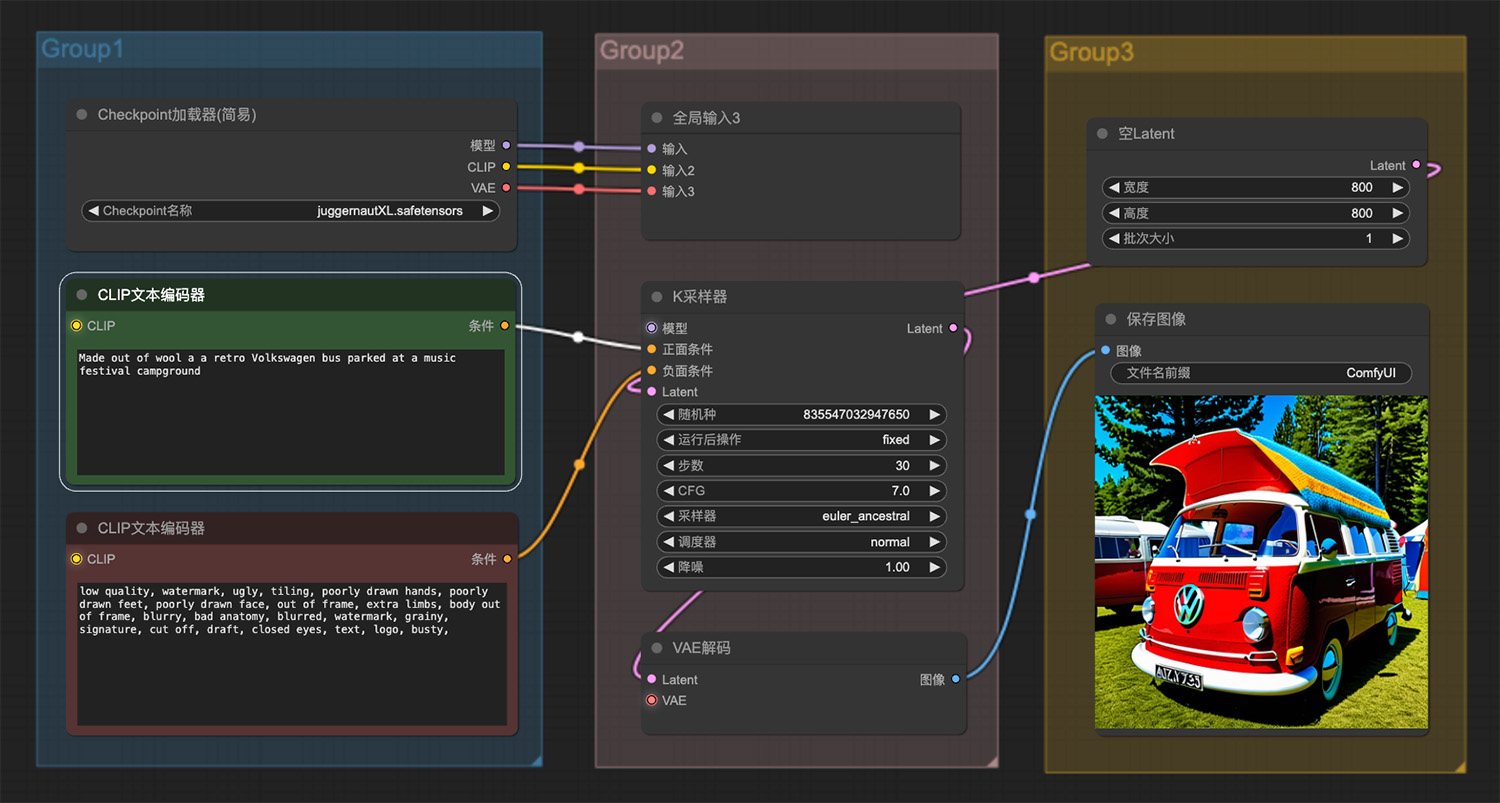 停在音乐节露营地的一辆复古大众巴士由羊毛制成
 一幅梦幻家园comfyui工作流
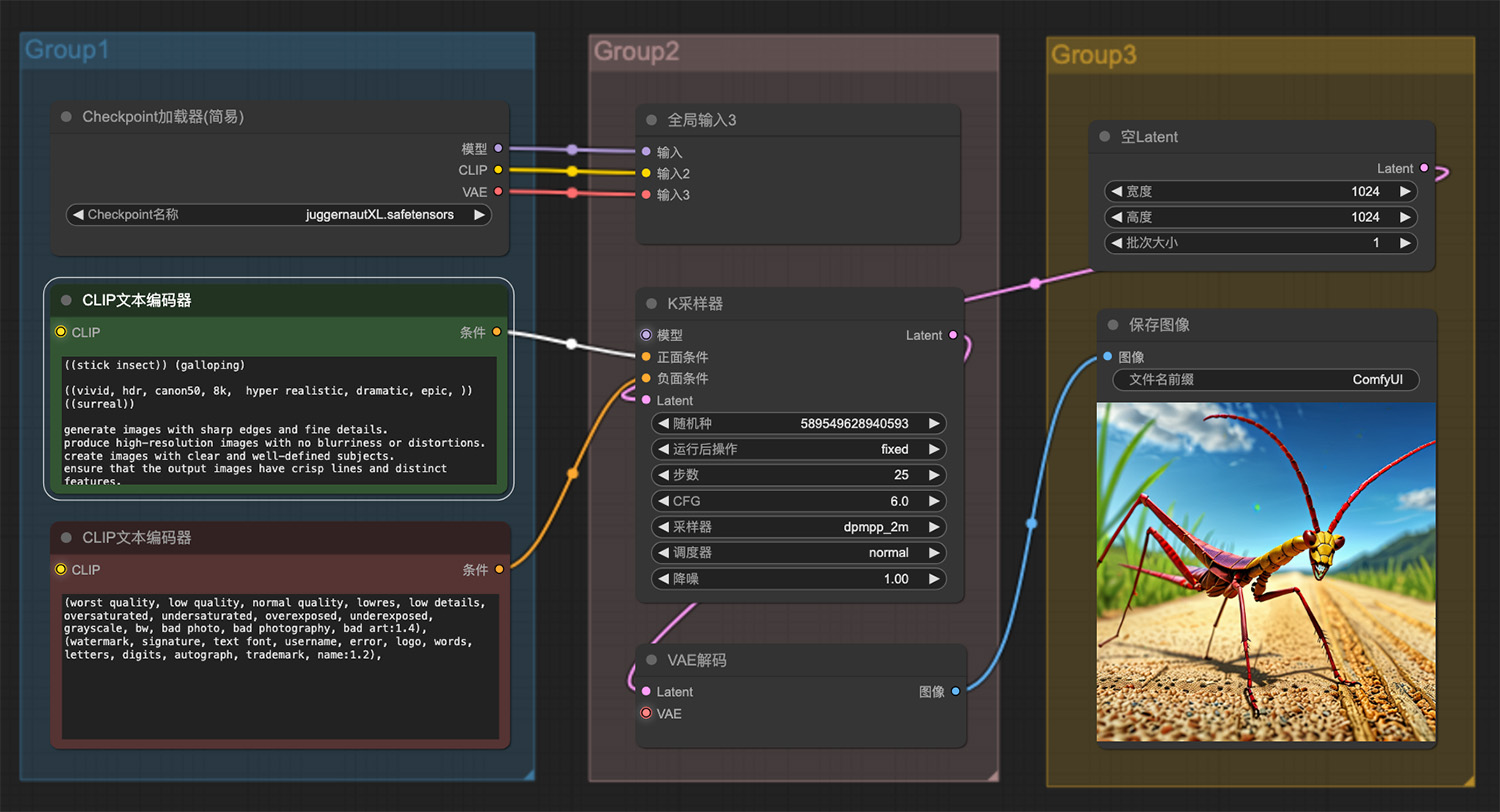 一只竹节虫ComfyUI工作流
 蘑菇屋,梦幻家园comfyui工作流
 一个红头发明亮眼睛的漂亮女人
 哈利波特魔法ComfyUI工作流
 一个港口配备了小型船只、起重机、集装箱和码头
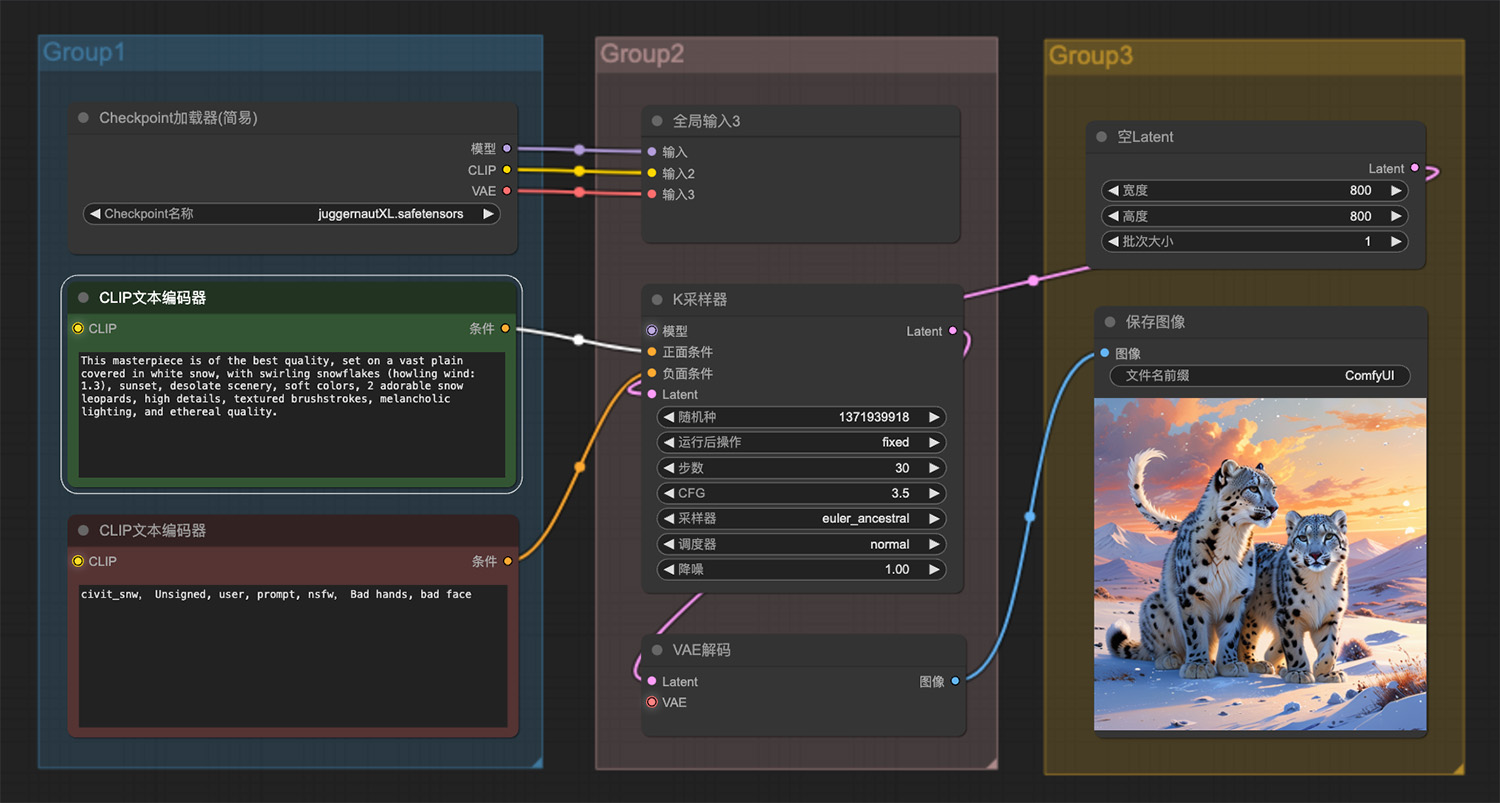 坐落在白雪覆盖的广阔平原上2只可爱的雪豹
 藏族日历小程序
 HTTPie AI
 iGPT
 Funnyskill API
 ModelsLab
 VibeReady
 Whacka
 Qdrant
 彝族日历小程序
 Mavis
 RunInfra
 Pablo
 QoderWork