 Kollavo
 Best API
 Flatkey AI
 Slock
 Trismik
 ZShip
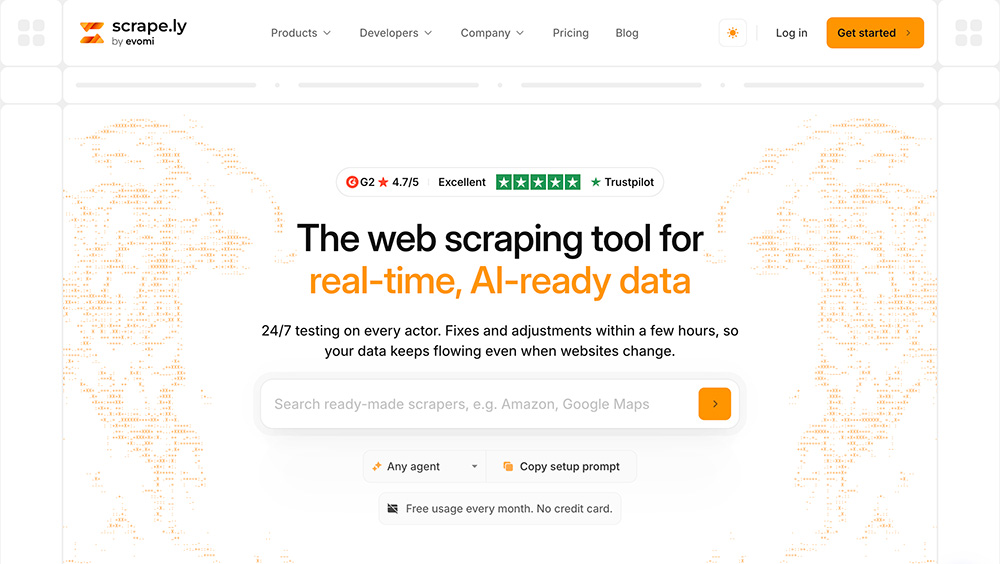
Scrape.ly是一个用于采集公开网页数据的云平台。用户不必自己写爬虫,直接在商店里挑选适配Google地图、Amazon、LinkedIn、Instagram、TikTok与各类评论网站的现成模板,填几个输入项即可拿到整洁的结构化数据,并导出为JSON、CSV或Excel。
需要自动化时,可通过REST API与SDK启动任务并读取结果;Claude、Cursor、VS Code、Codex等AI智能体则可连接托管在mcp.scrape.ly的MCP服务器获取实时网页数据。免费版每月含5美元使用额度,注册无需绑定信用卡。
一、产品核心功能:
1、现成爬虫商店:内置持续扩充的爬虫库,按目标网站搜索即可选用,把“写选择器、调试反爬”的工作替换成填表式操作。
2、主流平台覆盖:支持采集Google地图、Amazon、LinkedIn、社交媒体与评论网站的数据,覆盖获客、电商比价、招聘调研与口碑监测等常见需求。
3、结构化数据输出:采集结果直接整理为整洁的结构化字段,可导出JSON、CSV或Excel,拿到就能进表格分析或导入数据库。
4、云端代理与浏览器托管:代理轮换、无头浏览器与失败重试全部由云端承担,本地不需要维护采集环境或代理池。
5、全天候爬虫测试:每个爬虫持续接受测试,目标网站改版时能及时发现并修复,减少“昨天还能跑、今天全空”的断供情况。
6、REST API与SDK:开发者可用API启动任务并读取结果,把采集能力接进自有系统、脚本或数据管道,而不是只能手动点按钮导出。
7、托管MCP服务器:在 [https://mcp.scrape.ly](https://mcp.scrape.ly) 提供MCP服务,Claude、Cursor、VS Code与Codex等智能体可直接调用实时网页数据。
8、定时运行:支持按计划周期执行任务,价格、评论与商品信息可长期跟踪而不必每天手动触发。
二、典型使用场景:
1、Google地图挖掘潜在客户:按关键词与地区批量抓取商家名称、地址、评分与联系方式,形成可外呼或走访的线索清单。
2、电商平台价格与商品监控:持续跟踪Amazon等平台的价格、库存与商品信息,为定价与促销决策提供基线数据。
3、LinkedIn招聘信息调研:汇总岗位需求与技能关键词,判断某个职位的市场热度与能力要求变化。
4、品牌与地点评论监测:抓取评论网站的评价内容做情感倾向分析,及时发现口碑波动与集中投诉点。
5、Instagram与TikTok内容监测:跟踪账号内容与互动数据,用于达人筛选、竞品内容分析或campaign复盘。
6、为AI智能体供给实时数据:通过MCP让智能体在对话中直接获取最新网页信息,避免基于过时训练数据作答。
三、标准使用流程:
1、注册账号:在scrape.ly免费注册,无需绑定信用卡。
2、搜索目标网站:在商店中检索所需站点,例如输入“Google地图”。
3、填写输入项:打开爬虫,填入搜索词、地点与结果数量等参数,然后点击“开始”。
4、查看与导出结果:任务完成后在线查看,或导出为JSON、CSV、Excel。
5、接入自动化:需要批量或周期执行时,通过REST API启动任务,或把AI智能体连接到 [https://mcp.scrape.ly](https://mcp.scrape.ly) 的MCP服务器。
数据统计
特别声明&浏览提醒
本站AI工具导航站提供的「Scrapely」的相关内容都来源于网络,不保证外部链接的准确性和完整性。在2026年11月14日 08时37分59秒收录时,该网站上的内容都属于合规合法,后期网站的内容如出现违规,可以直接联系网站管理员(ai@ipkd.cn)进行删除,AI工具导航站不承担任何责任。在浏览网页时,请注意您的账号和财产安全,切勿轻信网上广告!
 DevChat
 Flaq AI API Platform
 WebToNative
 JellyToken智渲云
 Kili
 Aippy
 KimiK3 ai
 granthOS
 7款免费AI设计工具,让设计变得简单又有趣!
 11款法务AI助手,高效助力法律工作,提升专业效率
 几款免费AI视频转动漫神器,一键生成超酷动画片!
 5款免费AI商拍工具,一键生成爆款商品图
 几款免费AI绘图工具,一键生成流程图与办公图表
 5个免费AI漫画生成工具,一键开启漫画创作之旅!